Cet article Déployer un container Docker contenant ASP.NET 5 sur Microsoft Azure est apparu en premier sur Technologies e-business.
]]>Microsoft, quant à lui, a fait de sa plateforme Microsoft Azure une plateforme très ouverte à l’open source. Il est d’ailleurs désormais possible de faire tourner des applications ASP.NET 5, jusque-là réservées aux plateformes Windows, sur Linux et OSX.
Voyons comment toutes ces technologies s’utilisent ensemble, en déployant notre premier container Docker contenant une application ASP.NET 5 hébergée dans une VM Ubuntu dans Microsoft Azure.
Prérequis
Ce tutoriel a été réalisé sous Windows (mais est également réalisable sur Mac ou Linux).
Un compte Microsoft Azure est nécessaire pour déployer une machine virtuelle sur la plateforme. Si vous n’en disposez pas encore, vous pouvez vous inscrire gratuitement sur la plateforme pour une période d’essai à cette adresse.
Installation des outils d’administration Microsoft Azure
Nous allons utiliser les outils en ligne de commande qui sont basé sur Node.JS pour effectuer le provisionnement de notre machine virtuelle sur Azure. Le principal avantage de cet outil par rapport à Powershell est qu’il est disponible sur les trois systèmes d’exploitation : Windows, Mac et Linux. Ainsi, si vous n’êtes pas fidèle à un seul système d’exploitation, vous ne serez jamais dépaysé puisque les commandes seront toujours les mêmes.
Télécharger les outils en ligne de commande.


Pour ma part, je suis sous Windows, l’installation est effectuée grâce à Web Platform Installer.

Il suffit alors de cliquer sur « Installer » pour que l’outil s’installe sans intervention manuelle. Pour vérifier que l’outil est bien installé, il suffit de lancer une invite de commande et de lancer la commande :
azure
Si l’outil est correctement installé, vous devez obtenir un résultat identique à celui-ci :

Connexion à Microsoft Azure
Nous allons maintenant relier notre compte Azure à notre outil. Pour cela, nous allons télécharger le fichier de publication contenant l’ensemble des informations concernant notre abonnement, puis l’importer. Il faut lancer la commande suivante :
azure account download
L’utilitaire va ainsi ouvrir un navigateur internet, nous demander de nous identifier et nous rediriger vers l’URL : https://manage.windowsazure.com/publishsettings/index?client=xplat
Un fichier à télécharger va être soumis au téléchargement. Je vous conseille de bien noter où vous l’enregistrez. Pour ma part, je l’ai enregistré à la racine de mon disque D: sous le nom « azure.publishsettings ».
Ensuite, nous allons importer le fichier de publication précédemment enregistré en lançant la commande :
azure account import D:\azure.publishsettings

Une fois l’import effectué, vous pouvez vérifier que tout s’est correctement déroulé en lançant la commande suivante, qui va lister l’ensemble de vos abonnements Azure :
azure account list

Si votre abonnement Azure est bien listé, vous êtes prêt à déployer votre machine virtuelle Ubuntu.
Déploiement de notre hôte Docker
Un container Docker nécessite d’être déployé sur un hôte disposant du serveur Docker. Dans ce tutorial, nous allons utiliser une distribution Ubuntu car l’image est déjà présente dans la galerie Azure. Nous y installerons ensuite Docker et notre application.
Microsoft Azure propose une galerie d’images de différents systèmes d’exploitation (Windows, Ubuntu, CoreOS, Suse…) ainsi que plusieurs versions. Nous allons tout d’abord choisir une image de Ubuntu.
Pour lister l’ensemble des images disponibles, il faut utiliser la commande suivante :
azure vm image list
Une longue liste apparaît alors et il est difficile de faire son choix. Pour limiter la sélection aux machines Ubuntu, on peut alors utiliser la commande « grep » sur Linux ou « findstr » sur Windows.
azure vm image list | findstr Ubuntu-15_04
J’ai ainsi choisi la dernière image Ubuntu disponible à la date de cet article : « b39f27a8b8c64d52b05eac6a62ebad85__Ubuntu-15_04-amd64-server-20150422-en-us-30GB »
La commande azure vm create va nous permettre de créer rapidement une machine virtuelle sur laquelle nous pourrons nous connecter par la suite et y installer docker ainsi que notre application.
Ainsi, en utilisant l’image que nous avons sélectionnée, il suffit de lancer la commande suivante :
azure vm create --ssh 22 --location “West Europe” < vm-CloudServiceName> "b39f27a8b8c64d52b05eac6a62ebad85__Ubuntu-15_04-amd64-server-20150422-en-us-30GB" <username> <password>
où :
--ssh 22: permet d’ouvrir par défaut le port 22 qui va nous permettre d’administrer notre machine avec SSH ;--location “West Europe”: datacenter Azure où la VM sera déployée ;<vm-CloudServiceName>: DNS du Cloud Service de votre choix ;<username>: login de l’utilisateur root créé par défaut sur la VM ;<password>: mot de passe de l’utilisateur (au moins 8 caractères avec une minuscule, une majuscule et un caractère spécial comme !@#$%^&+=);
Dans mon cas, j’ai lancé la commande suivante :
azure vm create --ssh 22 --location “West Europe” ubuntudocker-mcklmt "b39f27a8b8c64d52b05eac6a62ebad85__Ubuntu-15_04-amd64-server-20150422-en-us-30GB" mcklmt Ubuntu!2015
Azure va tout d’abord créer un compte de stockage puis y déposer une copie de notre image Ubuntu. Enfin, une machine virtuelle basée sur cette image de disque va être instanciée.
Si tout se passe correctement, vous devez obtenir un résultat similaire à celui-ci :

La commande suivante va vous permettre de vérifier que votre VM a bien été créé :
azure vm list

Connexion à la machine virtuelle en SSH
Nous allons nous connecter à la machine virtuelle en utilisant SSH. Si vous êtes sous Windows, vous pouvez utiliser Putty. En lançant Putty, saisissez l’adresse de votre Cloud Service que vous venez de créer :

En cliquant sur « Open », Putty peut vous demander une confirmation de connexion telle que celle-ci :

Cliquez sur « Yes » pour accepter la connexion. Utilisez ensuite le couple login / mot de passe que vous avez choisi précédemment. Vous voilà connecté !

Installation de Docker
La commande est assez simple et se résume à :
sudo apt-get install docker.io
Si une confirmation vous est demandée, cliquez simplement sur “Y ». Lorsque la commande est terminée, vous devez obtenir un message similaire à celui-ci :

Création de notre container Docker
Pour créer un container Docker, il est possible de créer un container à partir de rien, ou bien de partir d’une image de base sur laquelle nous allons ajouter notre application. C’est cette seconde possibilité que j’ai retenue. J’ai donc choisi de déployer une application ASP.NET 5.
Pour récupérer cette application, j’ai choisi de télécharger directement les sources à partir du dépôt officiel du projet sur GitHub. La commande suivante va permettre de cloner le dépôt officiel dans le répertoire aspnet-Home sur notre machine virtuelle :
git clone https://github.com/aspnet/Home.git aspnet-Home

Rendons-nous dans le répertoire de l’application pour lister les fichiers :
cd aspnet-Home/samples/latest/HelloWeb
dir
Ces commandes doivent vous permettre d’observer le contenu du répertoire suivant :

La création d’un container Docker est régie par la présence d’un fichier « Dockerfile » qui permet de préciser le contenu du container. Créons simplement ce fichier en lançant la commande :
nano Dockerfile
Cette commande va permettre de lancer la création du fichier « Dockerfile » et de lancer l’éditeur de texte « nano ».
Ensuite, saisissez le contenu du fichier « Dockerfile » :
FROM microsoft/aspnet:1.0.0-beta4

COPY . /app
WORKDIR /app
RUN ["dnu", "restore"]

EXPOSE 5004
ENTRYPOINT ["dnx", ".", "kestrel"]
Enfin, validez par les commandes « CTRL + X », la touche « Y » pour enregistrer les modifications et enfin la touche « Entrée » pour valider le nom du fichier.

Explorons le contenu de ce fichier Dockerfile, ligne par ligne :
FROM microsoft/aspnet:1.0.0-beta4 : permet de préciser à Docker quelle image est la base de notre container. J’ai volontairement sélectionné une version plutôt que de prendre la dernière car le développement ASP.NET n’est pas encore stabilisé.
COPY . /app et WORKDIR /app : Docker va copier le contenu de notre application dans le container et changer le répertoire de travail.
RUN ["knu", "restore"] : Docker va lancer la restauration des dépendances qui sont présentes dans l’application.
EXPOSE 5004 : Docker va ouvrir le port 5004 afin que l’application puisse écouter les requêtes entrantes.
Enfin, la dernière commande ENTRYPOINT ["dnx", ".", "kestrel"] va permettre au serveur ASP.NET de se lancer dans le répertoire de notre application.
Il nous faut maintenant construire notre container. Rien de plus simple, il nous suffit de lancer la commande :
sudo docker build -t mcklmt-app .
où mcklmt-app est le nom de mon container.
Si vous obtenez un message similaire à celui-ci :

C’est simplement que le service docker est arrêté sur votre machine. Dans ce cas, il vous suffit de démarrer le service en lançant la commande : sudo service docker start et de relancer la construction de votre container.
Docker va télécharger l’image de base que nous avons choisie, ici, l’image de Microsoft ASP.NET va restaurer les dépendances de notre application et construire le container. Lorsque Docker a terminé son travail, vous devez apercevoir un message similaire à celui-ci :

La commande sudo docker images va permettre de vérifier que notre image est bien construite :

Lançons maintenant notre container :
sudo docker run –t –p 80 :5004 mcklmt-app

La commande sudo docker ps nous permet de vérifier que tout s’est correctement déroulé et que tout fonctionne correctement.

Exposer notre application sur internet
Nous avons presque terminé. Notre application est déployée dans notre container Docker. Il faut maintenant ouvrir le port 80 sur lequel notre machine virtuelle attend les requêtes sur le firewall Azure. Pour cela, revenons sur notre poste de travail où nous allons utiliser les outils en ligne de commande Azure pour créer un point de terminaison sur notre machine virtuelle.
Pour cela, lançons la commande :
azure vm endpoint create ubuntudocker-mcklmt 80 80
où ubuntudocker-mcklmt est le nom de la machine virtuelle.

Test depuis le navigateur
Vous pouvez désormais ouvrir votre navigateur à l’adresse de votre Cloud Service et vous devez apercevoir ceci :

Conclusion
Dans ce tutoriel, vous avez appris à manipuler les outils en ligne de commande Microsoft Azure pour administrer et automatiser votre infrastructure dans le Cloud. Si vous souhaitez déployer votre container sur une autre plateforme Cloud comme Amazon ou Google, c’est tout à fait possible en minimisant les actions de déploiement. Il vous suffit de ne redéployer que le container, ce qui est moins lourd que de déplacer une machine virtuelle.
Et pourquoi ne pas aller plus loin et déployer votre container sur un cluster Docker Swarm ?
Cet article Déployer un container Docker contenant ASP.NET 5 sur Microsoft Azure est apparu en premier sur Technologies e-business.
]]>Cet article Le Deep Learning pas à pas : l'implémentation (2/2) est apparu en premier sur Technologies e-business.
]]>L’enjeu majeur de la performance
Pour un informaticien, l’implémentation d’un DBN repose principalement sur le calcul de la formule (7)
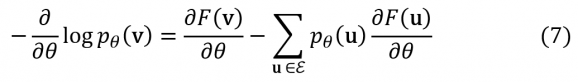
Malgré les simplifications astucieuses obtenues en utilisant l’algorithme de Contrastive Divergence et en choisissant les RBM comme briques élémentaires, les expressions mathématiques à évaluer restent très coûteuses en temps de calcul. La question de la performance des algorithmes est donc vitale pour tout outil ou langage destiné à ce champ d’application. A ce titre, toutes les solutions sérieuses disponibles aujourd’hui sont capables d’exploiter l’immense réservoir de puissance de calcul que constituent les ordinateurs modernes, aussi bien en sollicitant le processeur principal (CPU) que les processeurs graphiques dédiés (GPU). Ces derniers sont fabriqués par des fondeurs spécialisés de cartes graphiques comme NVidia ou AMD. Ils sont à l’origine prévus pour le calcul 3D dans le monde du jeu vidéo ou de l’imagerie de synthèse, ou plus récemment sur le traitement vidéo. Quel lien alors avec le sujet du Deep Learning ?
Les GPU ont des fréquences d’horloge bien moindres que celles des CPU (20x) mais ils possèdent de nombreux cœurs (unités de calcul). A titre d’exemple, sur une carte graphique de dernière génération de marque NVidia le GPU intègre 5760 cœurs pour 12Go de mémoire. Ces composants sont parfaitement adaptés aux traitements parallélisables de données de grande dimension (multiplication de matrices, convolution etc.). Par ailleurs, les fabricants se sont attelés à repousser encore plus loin les possibilités offertes par ce type d’architecture. Les technologies SLI (NVidia) ou Crossfire (AMD) permettent utilisation jusqu’à 4 GPU dans la même machine, démultipliant quasi proportionnellement la puissance de calcul. Les librairies comme CUDA (chez NVidia), avec ses extensions C ,C++, openAAC…, permettent aux développeurs de coder des applications accélérées matériellement par les GPU compatibles, tirant parti du parallélisme offert par la plate-forme. Lorsqu’il s’agit d’entraîner un réseau de neurones comportant plusieurs milliards de connexions ou d’essayer simultanément plusieurs modèles sur un jeu de données, cette aptitude à la parallélisation constitue un atout majeur.

Figure 1: Architecture GPU vs CPU
Des travaux récents produits en 2014, ont conduit à la construction d’un cluster de 64 GPU conçu spécifiquement pour l’entraînement d’un Convolutionnal Neuronal Network (CNN) à 18 couches de neurones pleinement interconnectées, soit 212.7M de poids synaptiques (w). Appliqué au cas d’usage académique Image Net Large-Scale Visual Recognition Challenge (ILSVRC) cette nouvelle architecture a décroché le nouveau record de taux de reconnaissance sur les 1,2 millions d’images classées dans 1000 catégories. Un résultat désormais supérieur à celui de l’œil humain !

Figure 2 : Photos extraites du catalogue ILSRVC. Expérimentations de légendages automatiques.
Une offre pléthorique d’outils et langages
Pour un data scientist désireux de s’aventurer dans le codage d’un réseau de neurones ou d’un DBN, les frameworks et langages à disposition sont nombreux. Les principaux ténors du sujet sont : Theano, un projet de l’université de Montréal, Torch, une solution maintenue par des experts œuvrant chez de grands acteurs du web (Google, Facebook ou Twitter) et Caffe, une initiative de l’université de Berkeley. De nombreuses autres alternatives sérieuses fonctionnent en sur-couche. Citons Pylearn2, une librairie Python de machine learning reposant sur des fondations Theano et une alternative, en mode boîte blanche, à l’incontournable sickit-learn. Ajoutons la librairie Python Keras, sur base de Theano également, mais réellement spécialisé dans le Deep Learning. On trouve également des projets exploitant Cuda-Convnet, une implémentation performante C++/Cuda des réseaux de neurones classiques. Comme dans tant d’autres domaines, force est de constater qu’il n’y a pas de solution ultime qui surclasserait toutes les autres. Chaque solution aborde le sujet avec une approche spécifique qui conviendra à telle ou telle communauté sans pour autant créer l’unanimité.
Theano, outil par excellence pour coder un DBN ?
Theano est un compilateur, transformant du code Python en instructions CUDA et permettant de faire de la programmation symbolique. Il n’est donc pas exclusivement réservé aux DBN. La communauté est importante et active, et la documentation est des plus complètes pour un produit open-source. Le principe est d’écrire le code, non pas comme un informaticien, mais plutôt comme un mathématicien et de déléguer à Theano le travail difficile et fastidieux de passer d’une formule mathématique à du code informatique efficace et performant.
Une somme ne s’écrit donc pas comme une boucle for mais comme une instruction Python Theano.SUM(). Le développeur ne calcule pas un dérivée numériquement [f(x+h)-f(x)]⁄h mais l’exprime naturellement avec une instruction déclarative du type Theano.grad(), en passant en paramètre un objet Theano.function(). C’est Theano qui dans la phase de compilation va opérer la transformation de ces déclarations Python en opérations informatiques optimisées. En outre Theano s’appuie entièrement sur le package scientifique standard NumPy, aucune révolution du côté de la syntaxe et des manipulations de base. Enfin le code compilé, sur les parties pertinentes de calcul, est directement exprimé en instructions CUDA.
L’intérêt majeur d’intervenir à ce bas niveau d’abstraction est la possibilité de spécifier intégralement, en boîte blanche, une architecture de réseaux de neurones. Les fonctions de coûts les plus exotiques ont toute leur place, et le calcul de leurs gradients/dérivés ne sera plus un casse-tête d’informaticien grâce à Theano. La liberté est donc maximale et particulièrement utile en cas d’expérimentation. Cependant cette liberté a un coût. Le travail de programmation symbolique est loin de faire l’unanimité et son accès n’est pas des plus aisés, a minima il nécessite une nouvelle façon de penser. Autre point non négligeable : la latence induite par la compilation de son travail, et celle-ci peut prendre plusieurs minutes suivant les cas. L’expérimentation étant partie intégrante de la datascience cela peut s’avérer frustrant. Ceci conduit certains développeurs de réseaux à envisager d’autres solutions spécialisées comme Torch ou Keras.
Pour illustrer le propos, ci-dessous des extraits de code Theano pour instancier une classe RBM. Les variables symboliques de Theano sont nommées ici vbias, hbias en place et lieu des paramètres a, b et w de la partie I de cet article.
# Paramètres a,b,w de la formule 5 préalablement initialisés dans le code
self.params = [self.W, self.hbias, self.vbias]
[...]
# Energie effective (formule 8) définit par :
def free_energy(self, v_sample):
vbias_term = T.dot(v_sample, self.vbias)
wx_b = T.dot(v_sample, self.W) + self.hbias
hidden_term = T.sum(T.log(1 + T.exp(wx_b)), axis=1)
return -hidden_term - vbias_term
[...]
# Implémentation de contrastive divergence pour obtenir un échantillon nv_samples
# distribués selon la probabilité souhaitée
[...] nv_samples [...] = theano.scan(
# fonction implémentant 1 step de deep sampling
self.gibbs_hvh,
# où chain start, une initialisation astucieuse par tirage d’une des
# configurations au hasard
outputs_info=[None, None, None, None, None, chain_start],
# Nombre d'itérations limitant le temps d'attente de la convergence
n_steps=k
)
[...]
# Déclaration du gradient de coût, où chain_end est le dernier élément de la chaîne

# nv_samples obtenu par l'échantillonnage de Gibbs précédent
cc = T.mean(self.free_energy(self.input)) - T.mean(self.free_energy(chain_end))
gparams = T.grad(cc, self.params, consider_constant=[chain_end])
cost = get_pseudo_likelihood_cost(gparams)
[...]
# Entraînement RBM , et calcul de la fonction de coût
train_rbm = theano.function(
[index],
# fonction de coût que Theano doit calculer
cost,
# nouvelles valeurs de toutes les variables partagées, ici self.params
updates=updates,
,[...])
Caffe : une approche « packagée »
A un niveau d’abstraction totalement différent, nous trouvons Caffe et son approche très opérationnelle. Il s’agit d’un exécutable dédié aux réseaux de neurones (non profonds) et développé en C++/Cuda. L’approche est davantage celle d’un framework, c’est çà dire un canevas général offrant une grande souplesse par paramétrage. Caffe est nativement utilisable en ligne de commande mais offre également des interfaces (wrappers) en Python ou même Matlab. Le cas échéant pour une personnalisation plus avancée, la librairie originale en C++ est accessible et pourra être re-compilée. Ce « moteur » construit ainsi des réseaux de neurones suivant les spécifications définies dans des fichiers plats à l’extension douteuse .prototxt. La syntaxe adoptée, Protobuffer (alternative à JSON) s’attache à décrire efficacement des structures d’objets, en texte plein, et donc aisément lisibles par un humain. On y trouve 3 types de déclarations d’objets à choisir parmi un catalogue bien fourni :
Blob: définition des données à manipuler dans le réseau. Nous y trouverons principalement le set de données d’entraînement, la liste de labels/catégories, les données en sorties du réseau de neurones.Layer: composant fondamental de Caffe. Définition du type d’opération à réaliser dans une couche donnée comme les convolutions, les filtres, l’application d’une fonction sigmoïde, le calcul de fonctions de coût usuelles …Solver: objet exclusivement dédié au paramétrage de l’entraînement du modèle constitué de l’ensemble des objets «Layers« . On y trouve le choix de l’utilisation d’un SGD, le nombre maximal d’itérations autorisées, l’activation du calcul via GPU…
Tout le travail consiste donc avec cette syntaxe « light » à empiler sur un jeu de données (Blob) des opérations d’activations (eq. Layers) dont la dernière est a fortiori une fonction de coût, à savoir un layer de type particulier EUCLIDEAN_LOSS, SOFTMAX_LOSS, HINGE_LOSS… Le nombre de neurones par couche est ajusté à l’aide du paramètre num_ouptut. En lançant l’apprentissage par invocation du Solver, Caffe va alors automatiquement itérer des allers-retours sur cette pile de Layers, le retour / back-propagation, se faisant lors du calcul de la fonction de coût. Par la suite, le calcul de gradient assuré de façon transparente par Caffe lui permet de réajuster les poids synaptiques.
Exemple de déclaration d’une couche d’un réseau de neurones avec Caffe :
layers {
name: "ip1"
type: INNER_PRODUCT # déclaration d’une couche/layer de neurones totalement connectés
blobs_lr: 1. # coefficient de learning rate pour les paramètres « filters »
blobs_lr: 2. # coefficient de learning rate pour les paramètres « biases »
# paramètres spécifiques au type de layer
inner_product_param {
num_output: 1000 # nombre de neurones
weight_filler {
type: "gaussian"
}
}
A noter enfin que Caffe ne possède pas (encore ?) de layer RBM ou Autoencoder spécifiques aux réseaux de neurones profonds. Nul doute alors qu’un Caffe pour DBN, ou équivalent, sur un mode très packagé, devrait voir le jour tant les espoirs sont grands concernant cette nouvelle classe d’algorithmes. Rendre leur implémentation plus accessible est une voie inéluctable.
Conclusion
Après des décennies de stagnation et d’échecs, les architectures profondes constituent un véritable « revival » des réseaux de neurones. Dans des disciplines comme l’IA, la reconnaissance visuelle où des progrès de quelques pourcent sont considérés comme de véritables percées, les architectures profondes occupent aujourd’hui une place de premier plan. Peut-on considérer pour autant que la pierre philosophale de l’IA a été découverte ? Assurément non.
Les espoirs déçus des années 50 nous ont trop enseigné la prudence. Des débats passionnants existent aujourd’hui dans la communauté de l’IA et du machine learning au sujet de la pertinence des architectures profondes dans l’objectif de réaliser une authentique IA. L’avenir est-il à l’imitation de la nature comme semble le penser les partisans des RN ? Les grandes inventions du passé, comme l’électricité ou le moteur à explosion, suggèrent plutôt que les grandes innovations ont tendance à s’en démarquer. Les architectures profondes semblent adaptées à la reconnaissance de formes mais elles ne semblent pas être capables de raisonnement logique. Même s’il est peu vraisemblable qu’une seule classe d’idées comme celles des Hinton et al. puisse venir à bout d’un problème aussi colossal que la conception d’une IA, les réseaux de neurones profonds feront assurément partie des recherches dans cette direction ces prochaines années.
Cet article Le Deep Learning pas à pas : l'implémentation (2/2) est apparu en premier sur Technologies e-business.
]]>Cet article De retour de Devoxx : Imaginons notre métier de développeur dans 20 ans est apparu en premier sur Technologies e-business.
]]>Cette année, les organisateurs ont souhaité nous faire réfléchir au métier de développeur informatique dans 20 ans. Chez SQLI, nous avons déniché une vieille carcasse de DeLorean, confectionné un convecteur spatio-temporel avec quelques Arduino (oui, oui, on peut, c’est écrit au fin fond du guide de référence), soudé quelques condensateurs : et hop ! Nous avons construit une machine à voyager dans le temps et avons été projetés jusqu’en 2035. Nous vous faisons un petit retour de ce que nous avons vu… à la sauce Future<Devoxx> !
Devoxx me up, Scotty*
Début 2000, Devoxx, était initialement une conférence basée à Anvers. Elle s’est ensuite ouverte à Paris au sein d’un Devoxx France en 2012, suivi de Londres en 2014, puis d’un Devoxx Pologne en 2015. Une nouveauté importante en 2015 : l’ouverture de Devoxx au continent Africain avec un nouveau pays Devoxxien : Devoxx Marocco.
En 2035, toutes les grandes villes européennes possèdent leur Devoxx. Après l’ouverture au continent Africain, c’est l’Asie qui s’y met rapidement et bientôt le concept Devoxx s’étend au monde entier.
Plus d’infos sur cette conférence sur www.devoxx.ma/fr
* Scottie, télé-devoxx-portation !
Prod? Where we’re going we don’t need Prod!*
En 2035, dans la plupart des entreprises, les serveurs ne seront plus des ressources gérées directement en interne. La Production – telle qu’on la connaît en 2015 – n’est plus. Les serveurs sont entièrement externalisés vers des services de Cloud (en 2015, on voit d’ailleurs de plus en plus d’acteurs présents sur le Cloud, Microsoft Azure qui étend son offre, IBM Bluemix). Chaque exécution d’application se traduit par une demande “CPU/mémoire/stockage/bande passante” définie en amont par les développeurs. Ceux-ci ne se soucient donc plus de savoir où sont publiées physiquement leurs applications mais seulement de ce dont elles ont besoin.
Apache Mesos qui permet de distribuer les applications sur différents modes d’exécutions, selon les ressources disponibles sur un ensemble de serveurs. Les besoins des applications peuvent évoluer de manière élastique et les nouvelles ressources disponibles sont prises en compte en temps réel. Les serveurs sont dorénavant des ressources d’entreprise, payées à la demande, au même titre que l’électricité ou le chauffage…
Quelques talks associés :
- « The end of server management : hosting have to become a commodity », par Q. Adam,
- « Mesos University », A. Maury et al.,
- « Bluemix, l’avenir du développement dans le Cloud », par J. Gauci,
- « L’écosystème Docker sur Azure », par P. Chanezon,
- « Scaling Docker with Kubernetes », par Carlos Sanchez.
* La Prod? Là où on va, on n’a pas besoin de Prod
Everybody remember where we (s)parked?*
Depuis longtemps, les frameworks et API aident à tirer parti de ces ressources, qu’elles soient distribuées sur plusieurs serveurs ou sur plusieurs cœurs. Les langages eux-mêmes sont pensés pour faciliter la distribution des calculs. Ils marient l’approche OOP à la démarche fonctionnelle et proposent nativement des instructions de parallélisation facilitant ainsi le développement d’applications réactives.
La généralisation des conteneurs (Docker menant toujours la danse), fait perdre l’intérêt des langages à compilation intermédiaire. Java, .NET, Scala, Groovy sont morts depuis longtemps en 2035… Tous les développeurs sont revenus sur des langages compilant en natif pour lesquels on compile pour une seule plateforme puisqu’elle sera conteneurisée. Tout le monde y gagne : les développeurs programment et compilent plus rapidement, les utilisateurs profitent d’exécutions plus rapides.
En 2035, ces types de langage (dont Go et Rust ont été les précurseurs) sont couramment mis en place pour les grosses applications distribuées en production.
Quelques talks associés :
- Initiation à Spark avec Java 8 et Scala, par H. Saleh & O. Girardot
- Go Tutorial, par F.Campoy Flores
- Refactoring to functional, par Hadi Hariri
- Présentation de Rust, par M. Poumeyrol et P. Baillet
- API Asynchrones en Java 8, par J. Paumard
* Quelqu’un sait où on spark ?
Sometimes the scariest things come from within…*
En 2035, JavaScript a disparu depuis quelques années… Mais il ne faut pas oublier qu’il a été LE langage de prédilection pendant un grande partie des années 2010 pour le développement Frontend… mais pas que. Il a été également présent côté serveur. Cette particularité assure ainsi au langage une capacité isomorphique. Pour aider cet isomorphisme, Browserify, a permis de modulariser le code de manière cohérente entre la partie cliente et serveur.
L’année 2015 a vu le Web faire un grand pas en avant avec notamment l’introduction des Web Components (et tout particulièrement son implémentation Google : PolymerJS) et des Web Workers. Nos développements Web s’en sont trouvés facilités et toujours plus robustes. Côté langage, en attendant la norme ES6, c’est TypeScript – une surcouche JS – qui se met en place, notamment dans un Framework très à la mode à l’époque : Angular 2. TypeScript offre l’avantage d’être typé, améliore la brièveté du code et sa lisibilité. C’est à cette époque que le JavaScript est finalement devenu l’assembleur du web laissant ainsi la place à des langages typés, qui sont dorénavant pris en compte par les navigateurs.
Quelques talks associés :
- « Se préparer dès maintenant à l’arrivée d’Angular 2″, par R. Linsolas
- « Modulariser son application AngularJS avec Browserify », par A. Richard
- » Typescript, le javascript statiquement typé », par B. Lemoine
- « WebComponents, Polymer and Material Design » par H. Gonzalez
*Parfois, les choses les plus effrayantes viennent de l’intérieur
Where did he learn how to negotiate (TCP) like that?
En 2015, les premières implémentations de http/2 voient le jour dans les navigateurs Web modernes et ce, même si la spécification ne sera finalisée que quelques années plus tard !
HTTP2 est orienté stream, permettant entre autre, de faire enfin des appels HTTP en parallèle, nativement sécurisés. Les développeurs prennent également conscience qu’il est temps de suivre l’adage « le bon outil pour le bon usage ». Http est omniprésent mais pas le plus adapté, notamment pour les communications des objets connectés. En 2035, les nouveaux protocoles sont partout. L’avènement des objets connectés en 2015 a forcé les entreprises à se tourner vers de nouveaux protocoles plus modulaires et plus réactifs que l’omniprésent Http. Les objets connectés s’appuient dorénavant sur des protocoles construits directement au-dessus de TCP ou UDP. C’est notamment le cas du protocole MQTT toujours aussi efficace pour faire du publish / subscribe.
Quelques talks associés :
- « HTTP/2: A deux c’est mieux! » par JF. Arcand
- « Comprendre l’IOT grâce à une boule… mais pas que », par L. Huet & P. Charrière
- « De l’API au protocole », par G. Couprie
* Où est-ce qu’il a appris à négocier (TCP) comme ça?
Some (entreprise) things never change… some things do*
Malgré les nombreux ouvrages démontrant les mauvaises pratiques de management de projet – notamment décrites dans le livre de F. Brooks « The Mythical man months » datant de 1975 (sic !) – certaines idées reçues ont la vie dure !
En 2035 (comme en 2015 d’ailleurs), beaucoup de sociétés tombent encore dans le panneau des idées reçues de l’informatique : ajouter des développeurs en plus en fin de projet pour limiter le retard, faire plusieurs projets en parallèle, chasser les très gros projets informatiques…
Quelques talks associés :
- « Les idées reçues de l’informatique : quand nos erreurs de raisonnement nous limitent », par L. Cinquin.
*Certaines choses (d’entreprise) changent, et d’autres ne changeront jamais
Can a robot turn a canvas into a beautiful masterpiece?*
En 2035, le monde est fortement robotisé. Après l’utilisation massive de la robotique pour l’industrie, les robots commencent à faire leur apparition dès les années 2020 pour apporter du service à la personne. Aider les personnes en situation de handicap moteur afin de faciliter leur déplacement, les assister ; mais également les personnes âgées souffrant de pertes de mémoire, et pour lesquelles, les robots vont aider à maintenir une socialisation.
Les robots sont également présents en tant qu’intelligence, pour aider tous les médecins à diagnostiquer certaines maladies en s’appuyant sur des intelligences partagées dont Watson est précurseur.
Les robots apprennent d’abord isolément à identifier leurs environnements. Puis collectivement, en transmettant leurs nombreuses données d’apprentissages qui sont stockées en masse, puis analysées par des algorithmes de Machine Learning, afin d’améliorer les prédictions et donc, en retour, l’intelligence de chaque robot. Mais attention, toutes ces données collectées sur les propriétaires des robots sont-elles utilisées à bon escient ?
Quelques talks associés :
- « Le futur de la robotique personnelle », par R. Gelin
- « Un robot peut-il apprendre comme un enfant ? » par PY. Oudeyer
- « Créer des applications cognitives avec IBM Watson Engagement Explorer et Bluemix », par P. Comte
- « La problématique du contrôle des technologies de l’information », par E. Fillol
*Est-ce qu’un robot sait transformer un bout de toile en magnifique tableau de maître ?
Always in motion the future is*
Nous sommes de retour dans le présent. Devoxx 2015 nous aura donné un avant-goût de ce que l’avenir nous réserve et nous aura permis d’anticiper notre futur de métier de développeur et plus généralement d’informaticien.
Cet article fait référence à une sélection des conférences que nous avons pu voir en tant que participants et que nous invitons à voir, ainsi que de nombreuses autres toutes aussi intéressantes, sur le site officiel de Devoxx, ainsi que prochainement sous forme de vidéo sur le site de Parleys.
Et comme disait le Doc’ « Le futur n’est jamais écrit à l’avance pour personne ; votre futur sera exactement ce que vous en ferez alors faites qu’il soit beau pour chacun de vous. »
* Toujours en mouvement le futur est
Article co-écrit avec Jean-François Garreau
Cet article De retour de Devoxx : Imaginons notre métier de développeur dans 20 ans est apparu en premier sur Technologies e-business.
]]>Cet article Le Deep Learning pas à pas : les concepts (1/2) est apparu en premier sur Technologies e-business.
]]>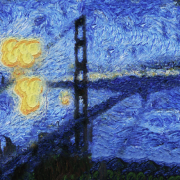 L’image ci-contre vous rappelle bien quelque chose ? On dirait…, mais oui, c’est la Nuit étoilée de Van Gogh ? Une Nuit étoilée où le Golden Gate Bridge remplace cependant le village bucolique de Saint Remy-de-Provence. Un simple pastiche «à la manière de » qui n’a a priori rien d’extraordinaire, si ce n’est que cette image a été construite numériquement à partir d’une simple photo du célèbre pont de San Francisco et d’une reproduction du chef d’œuvre impressionniste. Ce tour de passe-passe a été réalisé par Artomatix, une start-up irlandaise fondée en 2014 et spécialisée dans la conception de graphismes réalistes pour le cinéma et les jeux vidéo.
En 2012, Google a surpris la communauté du Machine Learning en démontrant que son Google Brain était capable de découvrir, par lui-même, des concepts de haut niveau tel que des visages, des corps humains ou des images de chats, ceci en épluchant des millions d’images glanées sur YouTube. Ce résultat est remarquable car jusque-là les techniques de reconnaissance d’images se basaient sur des approches dite supervisées, chaque image devant être explicitement désignée comme contenant un visage humain, une tête de chat etc. Le tour de force des équipes de Google a été de court-circuiter cette étape de labélisation manuelle (tagging). L’enjeu pour Google est énorme car il s’agit ni plus ni moins que de faire passer à l’échelle ses algorithmes d’apprentissage en tirant parti de la manne d’images disponibles sur le web qui, dans leur immense majorité, ne sont évidemment pas tagguées.
Le point commun entre ces deux applications du Machine Learning ? Les deux utilisent une classe d’algorithmes d’apprentissage automatique que l’on appelle le Deep Learning.
Sorti des labos de R&D depuis quelques années, le Deep Learning investit progressivement notre quotidien : la reconnaissance vocale de l’assistant Siri d’Apple, le tagging automatique de morceaux de musique, la synthèse vocale avancée, le légendage automatique d’images et même la conception de nouvelles molécules pharmaceutiques, toutes ces applications mettent aujourd’hui en œuvre des techniques de Deep Learning.
Cet article comprend deux parties. Dans la première partie nous présenterons en guise d’illustration l’une de ces architectures profondes : les Deep Belief Networks. Notre objectif est d’en donner une présentation conceptuelle détaillée et d’expliquer comment certaines avancées récentes sont parvenues à surmonter d’anciennes difficultés inhérentes aux systèmes de neurones. Une deuxième partie abordera les problèmes liés à l’implémentation des architectures profondes en général.
Cet article présuppose une connaissance rudimentaire des concepts du Machine Learning.
Flashback
L’idée de construire des réseaux de neurones (RN) artificiels n’est pas neuve, elle remonte à la fin des années 50. Très schématiquement l’idée consiste à s’inspirer du fonctionnement du cortex visuel des animaux. Dans une version élémentaire, chaque neurone i d’un tel réseau possède un niveau d’activation xi compris entre 0 et 1. Le schéma d’interconnexion entre neurones définit l’architecture du réseau. Une architecture classique consiste à organiser les neurones en couches successives avec des interconnexions limitées aux couches adjacentes comme le montre la figure 1 (a).

Figure 1 : (a) un RN organisé en 4 couches, (b) le mécanisme d’activation d’un neurone
Dans le cadre d’un apprentissage supervisé, un exemple classique d’utilisation d’un RN est celui d’un système chargé de classer des images de chiffres manuscrits. Dans cet exemple les niveaux d’activations xi(1) des neurones i = 1,…,k de la couche d’entrée correspondent aux niveaux de gris des pixels de l’image, k étant le nombre de pixels des images. La couche de sortie est en l’occurrence constituée de neurones yj,j = 0,1,…,9 qui correspondent aux dix chiffres que l’on peut attribuer à chaque image d’un ensemble d’entraînement. Les niveaux d’activation des neurones sont déterminés récursivement, couche par couche. Ceux de la couche n + 1 sont calculés à l’aide d’une fonction d’activation φ en fonction des niveaux d’activation des neurones de la couche n pondérés par certains poids synaptiques wij :
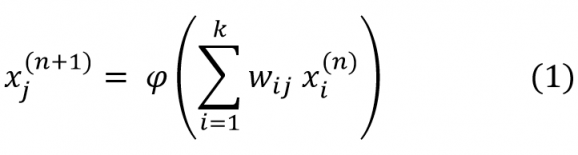
La somme porte sur tous les neurones i de la couche n connectés au neurone j de la couche n + 1, voir la figure 1 (b). La fonction d’activation φ est typiquement une fonction telle que la sigmoïde x → φ(x)≡sigm (x) représentée dans la figure 2. Elle est croissante, différentiable, non-linéaire et prend ses valeurs entre 0 et 1.

Figure 2 : fonction d’activation sigmoïde
L’entraînement du réseau consiste à trouver des poids synaptiques wij tels que la couche de sortie permette de classer avec précision les images d’un ensemble d’entraînement. On espère naturellement que le RN présentera des capacités de généralisation sur des exemples qu’il n’a jamais rencontré.
Une question se pose d’emblée : « De tels poids wij existent-t-ils toujours quel que soit l’objectif assigné au RN ? ». Par chance, un résultat mathématique connu sous le nom de théorème d’approximation universel, garantit que la chose est effectivement possible, même pour un réseau ne comportant qu’une seule couche cachée, à condition toutefois que φ soit non-linéaire et qu’un nombre suffisant de neurones soient mis en jeu en fonction de la marge d’erreur tolérée. En revanche si l’on se limite à des fonctions d’activation φ linéaires, le réseau fonctionnera comme une régression linéaire ordinaire et ne sera par conséquent d’aucune utilité pour prédire des phénomènes non-linéaires complexes.
Reste à construire un algorithme qui fournit une bonne approximation des poids wij en un temps acceptable.
Jusqu’à il y a peu l’algorithme phare pour l’entraînement des systèmes de neurones multicouches était l’algorithme dit de rétro-propagation. Pour fixer les idées, restons sur l’exemple des digits. Pour une image x = (x1,…,xk) en entrée et un ensemble de poids synaptiques w on commence par définir une fonction de coût C qui mesure l’écart entre les prédictions yj(x) des neurones de sortie et les valeurs cibles tj spécifiées dans l’ensemble d’entraînement :
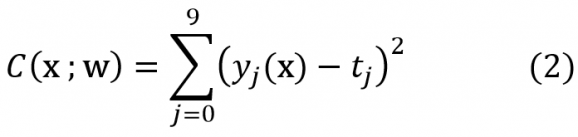
Naturellement yj(x) est une fonction extrêmement compliquée de la configuration x en entrée et des poids w, spécifiée par l’itération de (1). Ce que l’on cherche à minimiser en principe c’est la somme ou la moyenne CMSE(w) de ces erreurs sur toutes les configurations x de l’ensemble d’entraînement E :
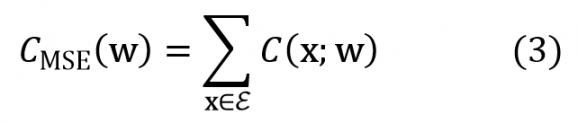
Une descente de gradient consiste à calculer la direction dans l’espace des poids w dans laquelle la décroissance de CMSE(w) est maximale. Cette direction est naturellement donnée par l’opposé du gradient ∇CMSE(w). Si tout se passe bien, c.à.d. qu’il n’y a pas de minima locaux, on s’approchera du minimum de CMSE(w) par itérations successives de petites corrections apportées à w :
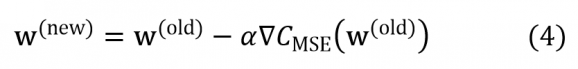
Le coefficient α permet d’ajuster la vitesse d’apprentissage, le cas échéant dynamiquement. Dans la pratique cependant, le calcul de la somme sur toutes les configurations x ∈ E est impossible car beaucoup trop coûteux en temps de calcul. Pour remédier à cette situation on utilise une descente de gradient stochastique (SGD) qui revient à approximer à chaque étape le gradient ∇CMSE(w) par le gradient ∇C(x;w) d’un seul échantillon x tiré au hasard dans l’ensemble d’entraînement[1] E. Cette stratégie qui peut paraître audacieuse a priori fonctionne car, intuitivement, les erreurs occasionnées par cette approximation se compensent sur le long terme. L’algorithme de SGD a fait ses preuves dans de nombreux problèmes d’optimisation et des résultats théoriques viennent étayer cette intuition dans certains cas particuliers.
Reste à calculer toutes les composantes ∂C(x;w )⁄(∂wij) du gradient ∇C(x;w). La calcul est simple dans son principe puisqu’il ne s’agit ni plus ni moins que de calculer la dérivée d’une fonction composée un peu compliquée définie récursivement par (1) et (2). C’est là qu’intervient l’algorithme de rétro-propagation, celui-ci permet d’organiser efficacement ce calcul de dérivée. Il s’avère que les dérivées par rapport aux wij associés à la couche de sortie sont élémentaires. Le reste du calcul procède par induction car on montre en effet que les dérivées par rapport aux wij de la couche n – 1 sont calculables dès lors celles de la couche n ont déjà été calculées. Ce calcul à reculons est à l’origine du nom de l’algorithme.
Tout astucieux qu’il soit l’algorithme de rétro-propagation souffre cependant de deux inconvénients majeurs :
- l’expérience montre que le temps d’entraînement d’un RN croît rapidement lorsque le nombre de couches augmente. C’est d’ailleurs l’une des raisons pour lesquelles à partir des années 1990 les RN ont été remisés au profit d’autres algorithmes non-linéaires moins gourmand en ressources comme les SVM.
- les RN n’échappent pas au problème central du Machine Learning : le surapprentissage.
Ces résultats empiriques sont en partie corroborés par des résultats en théorie de la complexité qui démontrent que l’entraînement d’un RN est un problème complexe dans un sens précis[2].
Pour progresser, de nouvelles idées sont nécessaires. Après plusieurs décennies de stagnation c’est G. E. Hinton[3] et son équipe qui, en 2006, ont fait la principale percée dans ce domaine.
Les idées nouvelles de Hinton
L’article fondateur de Hinton contient une série d’idées et de stratégies innovantes. Ce paragraphe les présente sur un plan intuitif, le suivant rentre dans les détails.
Un modèle génératif
Dans un contexte de classification supervisée, où l’on essaie d’apprendre une relation entre des observations x en entrée (les images de chiffres) et des labels y en sortie (les chiffres ‘0’ à ‘9’), la stratégie la plus courante consiste à construire un modèle discriminant, c.à.d. un modèle pour les probabilités conditionnelle p(y|x) d’observer un label y lorsqu’on connait l’entrée x. La régression logistique rentre par exemple dans ce cadre. Par contraste, la stratégie de Hinton et al. consiste à élaborer un modèle génératif, c.à.d. un modèle pour la distribution de probabilité conjointe p(y,x) des images x et des labels y. Autrement dit, on cherche à construire un RN capable d’apprendre puis de générer simultanément les images x et les labels y avec une distribution de probabilité proche de celle observée dans un ensemble d’entraînement.
Une fois le RN entraîné on pourra l’utiliser d’une part pour reconnaître des images, c.à.d. associer un chiffre y à une image x (on cherche le y qui maximise p(y|x)) ou, inversement, pour générer des images x correspondant à un chiffre y (on échantillonne p(x|y)). A ce stade, nous invitons vivement le lecteur à jouer avec l’application mise en ligne par Hinton qui illustre ces deux processus de manière visuelle et dynamique. Comme le veut l’adage : une image vaut mille mots, alors une vidéo…
Une initialisation rapide du RN puis un fine-tuning lent
L’architecture de RN utilisée pour réaliser le modèle génératif de Hinton et al. s’appelle un Deep Belief Network (DBN). Elle contient deux parties représentées dans la figure 3.

Figure 3 : Un Deep Belief Network qui identifie des images de digits
La première partie du DBN est constituée d’un ensemble de couches de compression qui convertissent les données entrées x en une représentation abstraite xabstrait. La seconde partie convertit cette représentation en labels de classification y.
La première partie a pour objectif d’apprendre la distribution des données x présentées en entrée sans tenir compte des labels y. Elle est constituée d’une succession de couches dont chacune contiendra une représentation plus abstraite (ou compressée) que la précédente. Pour ancrer l’intuition considérons un RN chargé de classifier des images. La première couche stockera les niveaux de gris de l’image (l’équivalent de la rétine), la seconde contiendra, par exemple, un encodage des lignes ou des zones de contraste de l’image, la troisième détectera l’existence de certaines formes géométriques simples comme des cercles, la quatrième identifiera certains agencements particuliers de ces figures comme celles qui représentent un ‘8’ formé de deux cercles juxtaposés et ainsi de suite. Ainsi on automatise en quelque sorte le processus de feature engineering manuel du machine learning. Hinton et al. ont par ailleurs découvert un algorithme rapide pour entraîner cette première section en procédant couche par couche (nous y reviendrons). Une fois entraînée, cette première section du RN contiendra une représentation hiérarchique des données en entrée, la dernière couche encodant la représentation xabstrait la plus abstraite et aussi, c’est l’idée, la plus utile. Cette première phase peut être conçue comme une initialisation efficace du DBN, on l’appelle aussi pré-entraînement.
Le rôle de la seconde partie du DBN est de convertir la représentation abstraite et obscure xabstrait en labels y utilisables par exemple dans le cadre d’un apprentissage supervisé. Dans l’exemple des digits cette représentation sera constituée d’une couche de sortie de dix neurones, un neurone par digit. Cette conversion peut être réalisée au moyen d’une couche logistique entraînée par une SGD classique.
L’entraînement du DBN est considéré comme achevé lorsque la performance du DBN évaluée sur un ensemble de validation distinct de l’ensemble d’entraînement ne progresse plus significativement. Cette seconde étape est appelée le fine-tuning, elle est généralement beaucoup plus lente que l’initialisation.
Les RBM comme briques de base
Pour mener à bien le programme esquissé dans les deux paragraphes précédents il faut disposer d’une brique de compression (c.à.d. un morceau de RN) qui implémente les couches de la première section. La principale caractéristique attendue de cette brique est sa capacité à apprendre rapidement une distribution de probabilité spécifiée empiriquement par un jeu d’exemples. Il existe pour cela différentes alternatives[4] qui permettent peu ou prou d’implémenter la même philosophie mais nous nous restreindrons dans cet article à la description des Restricted Boltzman Machines (RBM) utilisés par Hinton et al. dans leur travail pionnier de 2006.
Le paragraphe suivant explique ce que sont les RBM et comment l’algorithme dit de Contrastive Divergence de Hinton et al. exploite astucieusement leurs propriétés.
Zoom sur les RBM
Deux propriétés qui simplifient la tâche
Les RBM sont des RN stochastiques, qui peuvent être entraînés sur un mode non supervisé pour générer des échantillons selon une distribution de probabilité complexe spécifiée par des exemples (l’ensemble d’images de digits p.ex.).
Alors que les neurones des RN évoqués dans la section Flashback ont des niveaux d’activation xi déterministes compris entre 0 et 1, les neurones des RBM sont des variables aléatoires binaires. Elles sont réparties sur deux couches. L’une de ces couches est appelée la couche visible, c’est elle qui encodera les exemples de l’ensemble d’entraînement E. Notons collectivement v = (v1,…,vk) les niveaux d’activation de ces k neurones. L’autre est appelée couche cachée, c’est elle qui stockera une forme compressée ou abstraite des données de la couche visible. Notons h = (h1,…,hl) les niveaux d’activation correspondants.

Figure 4 : Une RBM est constituée d’une couche de neurones visibles et d’une couche de neurones cachés
Par définition, une RBM est définie par la distribution de probabilité conjointe suivante[5] sur v et h :
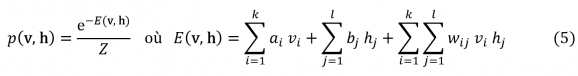
Les grandes valeurs de E(v,h) correspondent à de probabilités p(v,h) faibles. La physique statistique utilise des formules similaires pour attribuer des probabilités p(x) à certaines configurations d’un système thermique. Dans un tel cadre E(x) s’interprète essentiellement comme l’énergie de x. L’intuition derrière la formule (5) est donc que les configurations (v,h) les plus probables sont celles dont l’énergie E(v,h) est minimale. Remarquons que les poids wij ne connectent que les hi et les vj mais pas les hi entre eux ni les vj entre eux, c’est là l’origine de l’adjectif « restricted », voir la figure 4. Les paramètres a, b et w sont à optimiser durant l’entraînement. Pour simplifier l’écriture nous les désignerons globalement par θ.
Ce qui nous intéresse au premier chef c’est la distribution marginale pθ(v) = ∑hp(v,h) des variables visibles v de la RBM (la somme porte sur toutes les configurations h possibles des neurones cachés et l’indice θ rappelle la dépendance de p). L’optimisation de θ a pour objectif de maximiser la ressemblance entre la distribution marginale pθ(v) générée par la RBM et la distribution expérimentale observée au sein de l’ensemble d’entraînement E. Pour cela on va maximiser la vraisemblance ∏v∈Epθ(v) des valeurs observées v. Pour reformuler le problème comme la recherche du minimum d’une fonction de coût qui est une somme de contributions associées à chaque v ∈ E on passe au logarithme et on change le signe :
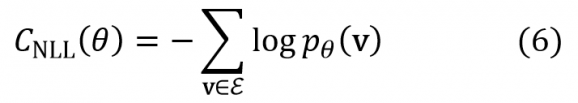
L’acronyme NLL signifie Negative Log Likelihood. On peut alors appliquer à CNLL la même stratégie d’optimisation par SGD qu’avec CMSE. Il suffit pour cela de savoir calculer la dérivée de chaque terme dans (6). Pour simplifier les expressions qui suivent on introduit généralement, en parallèle avec l’énergie E(v,h), la notion d’énergie effective F(v) définie par pθ(v) ≡ e-F(v)⁄Z. En utilisant les définitions on trouve :
Deux propriétés des RBM liées à la forme spécifique de l’énergie E(v,h) définie en (5) vont grandement nous simplifier la vie. Ce sont elles qui motivent en définitive le choix des RBM comme briques élémentaires des DBN.
- L’énergie effective F(v) qui intervient dans (7) est calculable facilement au moyen d’une formule explicite :
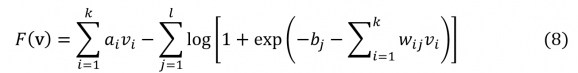
Sans le secours de la formule (8) il faudrait calculer une énorme somme sur toutes les configurations h, une somme dont le nombre de termes croit exponentiellement avec le nombre l de neurones cachés. Rappelons en effet que e-F(v) = ∑he-E(v,h) . - Les neurones d’une couche sont conditionnellement indépendants lorsque les activités des neurones de l’autre couche sont fixés, explicitement (par économie on supprime l’indice θ de pθ) :
 Un calcul simple montre par ailleurs que les probabilités conditionnelles individuelles sont données par la fonction sigmoïde :
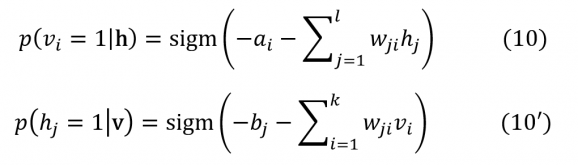 On retrouve donc la fonction d’activation usuelle mais avec une interprétation stochastique. Comme on le verra les propriétés (9,9’) et (10,10’) sont cruciales pour échantillonner efficacement la distribution pθ qui intervient dans la somme dans (7).
Le calcul de la somme dans (7) s’avère cependant impraticable pour des grands ensembles d’entraînement[6] car cela prendrait trop de temps. Il faudra par conséquent nous contenter de l’approximer en n’utilisant qu’un nombre limité de termes échantillonnés selon une distribution proche de pθ(v). C’est là que les propriétés d’indépendance conditionnelle précédentes viennent à la rescousse.
L’algorithme de Contrastive Divergence
Pour échantillonner une distribution de probabilité multivariée p(x) = p(x1,…,xr) les méthodes dites Monte-Carlo Markov-Chain (MCMC) sont souvent indiquées. Elles permettent de générer itérativement une succession infinie d’échantillons x(1), x(2)… qui, à la longue, seront distribués selon une distribution p(x) souhaitée. Pour les RBM on utilise une version particulière de MCMC dite avec échantillonnage de Gibbs. Concrètement cela signifie que l’échantillon x(n+1) de la MCMC est généré à partir de l’échantillon x(n) en r étapes (où r est le nombre de variables que contient x). A chaque étape on génère une nouvelle composante xi en utilisant la probabilité conditionnelle p(xi│x_i ) où x_i désigne x dont on a retiré la variable xi. Dans le contexte des RBM qui nous intéresse x = (h,v) et les probabilités conditionnelles sont données par les expressions (10) et (10’). Tout l’intérêt de cette propriété d’indépendance conditionnelle propre aux RBM est qu’elle permet de paralléliser l’échantillonnage de Gibbs. On va ainsi échantillonner simultanément tous les hi connaissant les vj puis, dans un second temps, simultanément tous les vj connaissant les hi, explicitement :
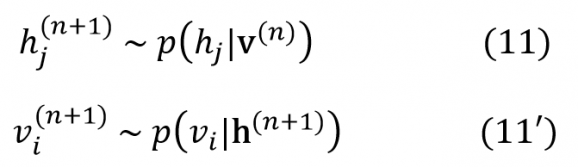
Bonne nouvelle, au lieu d’avoir r = k + l étapes il n’y en a donc finalement que deux étapes parallélisées !
Hélas, en dépit de cette bonne nouvelle du parallélisme, il reste un problème de taille. Notre objectif, rappelons-le, est d’optimiser par itération successives les paramètres θ de la RBM au moyen d’une SGD. Or chaque itération exige le calcul du gradient (7) qui à son tour demande, du moins en principe, d’attendre que la convergence de l’échantillonnage MCMC vers pθ s’installe, ce qui est évidemment irréaliste.
Hinton et al. utilisent deux astuces pour surmonter cette difficulté. Elles constituent l’algorithme de Contrastive Divergence[7] (CD). Comme la distribution pθ est sensée être proche de la distribution expérimentale dans E on peut accélérer la convergence de la MCMC en l’initialisant avec un échantillon tiré de E. Ensuite, plutôt que d’attendre patiemment la convergence de la MCMC, on arrête les itérations après un petit nombre d’étapes. Et même, en étant un peu audacieux, après une seule étape ! Ce faisant on commet évidement une erreur puisqu’on ne génère pas exactement pθ. L’expérience montre cependant que les itérations de la SDG finissent par lisser cette erreur et que cette approximation grossière reste suffisante pour faire converger la fonction de coût CNLL(θ) vers un minimum approximatif utile.
Empilement et fine-tuning
Nous voici donc équipé pour entraîner efficacement une RBM. Un DBN consiste comme nous l’avons expliqué en un empilement de RBM et une couche logistique supplémentaire qui converti le contenu de la couche cachée du dernier RBM en labels de classification. L’entraînement d’un DBN complet procède alors selon les étapes suivantes :
- la RBM n°1 est entraînée par CD avec les échantillons v de l’ensemble d’entraînement E présentés sur sa couche visible ;
- une fois entraînée, cette première RBM fera office de convertisseur/compresseur. A chaque échantillon v de l’ensemble d’entraînement E elle associe une configuration h de neurones de la couche cachée. On construit h en échantillonnant les distributions pθ(hi│v) avec les paramètres θ appris à l’étape précédente. On peut montrer[8] que les configurations h ainsi obtenues sont des versions compressées des v. Les h sont utilisées comme échantillons d’entraînement présentés à la couche visible de la RBM n°2 ;
- on itère 1. et 2. sur toutes les RBM du DBN. Une fois toutes les RBM entraînées, la phase d’initialisation est terminée. On dispose alors d’un mécanisme complexe de conversion des v en une représentation abstraite/compressée sur la couche cachée de la dernière RBM. C’est une forme de feature engineering automatisé ;
- on peut alors utiliser cette représentation abstraite en entrée d’une couche logistique que l’on entraînera de manière classique avec une SGD supervisée basée sur une fonction de coût CNLL de type maximum de vraisemblance. C’est l’étape dite de fine-tuning.
Ce paragraphe clos la partie conceptuelle de cet article. Cependant le phénomène récent du Deep Learning n’est uniquement le résultat de progrès conceptuels. Comme nous le verrons dans un prochain article, de nombreuses avancées technologiques ainsi que la mise à disposition de nouveaux outils de programmation, promus par les grands acteurs de l’IT, alimentent également cet engouement.
Lire la suite « Le Deep Learning pas à pas : l’implémentation »
[1] Il existe des variantes où l’on calcule le gradient de petites sommes que l’on appelle mini-batch.
[2] Il a été démontré que la recherche de poids optimaux dans un RN multicouches est un problème NP-complet.
[3] G.E. Hinton est professeur émérite à l’université de Toronto et chercheur chez Google.
[4] Les principaux sont les auto-encodeurs et les réseaux de convolution, voir cet article p.ex.
[5] La constante Z garantit que p(v,h) est bien une distribution de probabilité, on l’appelle la fonction de partition.
[6] Pour le problème de reconnaissance des digits |E|=50’000 à titre d’exemple.
[7] L’origine de cette terminologie de divergence de Kullback Leibler qui mesure le degré de dissimilarité entre deux distributions de probabilité.
[8] Voir par exemple cet article pour une justification intuitive basée sur l’idée de groupe de renormalisation.
Crédit image : (c)Artomatix
Cet article Le Deep Learning pas à pas : les concepts (1/2) est apparu en premier sur Technologies e-business.
]]>Cet article Modulariser son application AngularJS avec Browserify est apparu en premier sur Technologies e-business.
]]>D’aveu de développeur, node.js est une plateforme très agréable à programmer. Elle bénéficie notamment :
- d’un gestionnaire de packages efficace – npm – et d’un dépôt public associé, portés par une société solide et une communauté Open Source prolifique et de qualité,
- d’un système de modularisation – basé sur le standard CommonJS – qui favorise la production de petits programmes spécialisés que l’on va ensuite combiner entre eux pour obtenir des comportements avancés.
Cet article présente les intérêts d’utiliser ces mécaniques venues du back-end, pour développer nos front-end web, notamment avec le framework AngularJS.
Le code présenté dans cet article est issu d’une application d’exemple affichant une liste de “mets gastronomiques” (dishes en anglais) à l’écran. Retrouvez-la sur Github.
npm
npm est le gestionnaire de packages de node.js (il est inclus dans l’installeur). L’équipe d’AngularJS publie chaque version du framework sur npm. Il est donc possible d’installer le framework dans notre projet ce cette façon :
$ npm install [email protected] --save-dev
Angular est ainsi téléchargé dans un dossier node_modules et inscrit en tant que dépendance de développement dans le fichier package.json décrivant notre application.
npm a pour vocation d’héberger toutes nos dépendances Javascript, qu’elles soient destinées au back-end ou bien aux navigateurs. Il remplace ainsi avantageusement Bower.
CommonJS
Dans un environnement CommonJS comme node, chaque fichier constitue un module de code isolé des autres (ce qui n’est pas le cas dans nos navigateurs). Chaque fichier va alors déclarer ses dépendances à l’aide du mot clé require et exposer son API via exports ou module.exports (à retrouver ici).
Dans ce cadre, pour utiliser l’API d’AngularJS, par exemple pour créer un module, nous allons écrire ceci :
var angular = require(‘angular’);
angular.module('dishes', []);
Nous pouvons également utiliser require pour nos propres fichiers en précisant un chemin relatif :
var truc = require('./truc.js'); // l’extension .js est facultative
Je vous propose d’utiliser ce mécanisme pour structurer notre code AngularJS de la façon suivante :
- Chaque élément (fonction) de notre logique métier sera implémenté en pur Javascript et stocké dans son propre fichier,
- L’assemblage de ces différents éléments via framework AngularJS aura lieu ailleurs, dans un fichier responsable de la configuration applicative.
Voici ce que nous obtenons concrètement sur une factory Angular tirée du projet d’exemple :
Le fichier src/dishes/data/dishes.js expose une fonction implémentant la logique de notre factory :
module.exports = function() {

 var dishes = [
   { name: 'Galette-saucisse', type: 'Plat principal', image: 'images/1.jpg' },
   /* ... */
 ];

 return {
   list: function() {
     return dishes;
   }
 }

};
Le fichier src/dishes/index.js, créé un module AngularJS et instancie chacun de ses composants :
var angular = require('angular');

angular.module('dishes', [])
 .factory('dishesData', require('./data/dishes'))
 .controller(/* ... */);
Les avantages d’une telle structuration sont multiples :
- La maintenabilité de notre application est améliorée grâce à la séparation de la logique métier et de l’assemblage de ces différentes briques avec AngularJS,
- La logique métier étant uniquement portée par du code Javascript/CommonJS, elle ne nécessite pas de navigateur pour être testée unitairement : nos tests seront exécutables directement dans node (avec mocha par exemple),
- Si votre code serveur est écrit en node.js, vous partagez le même standard de modularisation entre vos sources client et serveur.
Browserify
Il nous reste un petit détail à régler : un code tel que présenté ci-dessus n’est pas exécutable directement dans nos navigateurs (qui ne supportent pas CommonJS)… C’est là qu’intervient la magie de Browserify ! Cet outil permet de transformer du code CommonJS en code exécutable par les navigateurs. Une fois Browserify installé (via npm install -g browserify), nous pouvons transformer notre code à l’aide de la commande :
$ browserify src/app.js > bundle.js
src/app.js étant le point d’entrée de notre application, et bundle.js le fichier transformé par Browserify. Ce « bundle » porte l’ensemble de notre code et ses dépendances. Pour l’utiliser, il suffit de le référencer dans notre index.html :
<script src="bundle.js"></script>
N’hésitez pas à aller plus loin en parcourant le code présent sur le dépôt Github.
Cet article Modulariser son application AngularJS avec Browserify est apparu en premier sur Technologies e-business.
]]>Cet article Comprendre l’IOT avec une boule… mais pas que... est apparu en premier sur Technologies e-business.
]]>L’objectif de notre présentation était de présenter notre vision de l’“internet of things” en parlant des grands principes (définitions, protocoles, objets, architectures, outils…), tout en les illustrant par 4 démonstrations avec de vrais objets connectés (montrer comment faire son propre internet of things). Le 3ème protagoniste de cette présentation était une Sphero (une boule lumineuse et colorée, télécommandée par smartphone) qui a participé à 2 des 4 démonstrations. Chacune des démonstrations permettait de montrer différentes configurations d’objets connectés plus ou moins complexes et autonomes.

Je vais tenter dans cet article d’extraire les idées les plus significatives de cette présentation. Je définirai donc ce qu’est (selon moi) un objet connecté, ce qu’est l’internet des objets et expliquerai de quelle manière et avec quels outils nous avons réalisé certaines de nos démonstrations.
Qu’est-ce qu’un objet connecté ?
On parle aussi de “Thing”. Donc, un objet connecté c’est une “chose” constituée d’un ensemble de composantes (des propriétés et des API). Cet objet a généralement une sensibilité à l’environnement par le biais de capteurs : position, température, humidité, hygrométrie, pulsations cardiaque (pensez aux montres connectées ou aux bracelets connectés).
Ensuite par différents moyens, ce même objet est relié à un mode de visualisation embarqué (les informations de la montre par exemple, la couleur de la Sphero…) ou distant (des dashboards pour afficher la température de votre maison dans un navigateur ou sur votre smartphone). Cet objet va avoir également une interactivité plus ou moins poussée avec d’autres objets (la Sphero ou la montre connectée avec un smartphone, un maillage de capteurs…), mais aussi une autonomie plus ou moins grande (durée de vie d’une batterie, piles, secteur), et enfin, mais non des moindres, une identité : pour gérer et reconnaître les objets il faut savoir les identifier.

Qu’est-ce que l’internet of things ?
On parle de “Internet of Things”, mais aussi de “Web of Things”, et même d’“Internet of Everything”. Essayons d’expliquer ce que c’est en replaçant les “Things” dans leur contexte.

Dans un premier temps, nous avions des objets isolés (bien que ce soit discutable pour une télévision), puis est apparu le concept du “Machine To Machine” où la technologie permet de faire “discuter” les machines entre elles et de les contrôler à distance (pensez à tout ce qui est surveillance à distance par exemple), et enfin depuis peu, est apparu l’IOT : des objets du monde réel transmettent (et reçoivent pour certains) des informations à travers le réseau internet, permettant ainsi de construire des “maillages d’objets” même à grande distance pour élaborer des systèmes de plus en plus intelligents (par exemple: les smart grids ou la distribution intelligente de l’électricité). Retenez, que tout est potentiellement “connectable” et en mouvement avec l’arrivée des montres connectées, des vêtements connectés… que votre domotique est en pleine mutation, et qu’il reste encore de nombreux cas d’usage à inventer.
Un marché en pleine expansion
L’IOT représente un marché à expansion rapide, notamment grâce à des modes de connectivité accrue : en effet, nous disposons tous du Wifi, de la 3G, de la 4G et d’appareils Bluetooth. Mais d’autres facteurs techniques, tels que l’augmentation des performances et de la puissance de calcul, la miniaturisation, l’autonomie (pensez à votre smartphone) contribuent aussi fortement à cette expansion. Les facteurs économiques sont également favorables, nous pouvons observer une baisse des coûts de production de matériel (regardez les prix des composants électroniques, des micro-controllers comme Arduino ou encore des nano-computers comme le Raspberry PI). Le phénomène du Crowdfunding permet aussi l’émergence de nombreux projets qu’il n’y a encore pas si longtemps, n’auraient pu voir le jour.
La diversité des “Things” remporte l’adhésion du grand public et contribue donc grandement au marché de l’IOT.

Les objets connectés deviennent de plus en plus complets et puissants, avec des usages multiples (de l’utile au purement récréatif, la Sphero par exemple, qui est une boule télécommandée par votre smartphone) et, j’en parlais plus haut, certains ont la capacité d’utiliser des langages et des technologies avancées ; prenez par exemple le Raspberry PI, c’est un ordinateur pas plus gros qu’un paquet de cartes à jouer qui embarque un système d’exploitation Linux complet, ou même du Windows 10 dans sa dernière version.
Mais comment ça fonctionne ? Et comment le faire soi-même ?
Nous disposons ainsi de nombreux objets susceptibles de communiquer et d’agir, mais pour que cela ait une quelconque utilité, il faut mettre en place des systèmes, des architectures capables d’échanger des informations avec les things, de les identifier mais aussi capables de stocker, chiffrer, restituer… toutes les données générées par les things (des capteurs de température qui émettent toutes les 30 secondes pendant des mois, des montres connectées couplées à des smartphones qui comptent des pas, qui enregistrent des pulsations cardiaques, qui diffusent des coordonnées géographiques…).
Lors de notre présentation, nous avons illustré ce qu’était un projet IOT à partir de démonstrations avec des objets réels et notamment en commençant (et finissant) avec une Sphero (d’où le titre de notre présentation). La Sphero, dont nous avons détourné l’usage initialement ludique, était donc l’objet connecté parfait pour une présentation. Vous allez comprendre pourquoi.
Un projet “IOT”, peut être découpé en 4 parties principales :
- les things (objets, périphérique…),
- les infrastructures (les serveurs qui vont communiquer avec les things, dans le cloud ou ailleurs),
- le stockage des données,
- l’utilisation des données.

Pour les besoins de la présentation, une des démonstrations mettait en œuvre ces 4 parties, de manière plus ou moins avancée, pour illustrer et faire comprendre les concepts.
Remarque : pour simuler internet, nous avions notre propre routeur wifi.
Echanger des données avec une Sphero à travers le Web
Partie 1 : les “Things”
Dans le rôle de l’objet connecté, nous avions choisi la Sphero pour les avantages suivants :
- elle peut se déplacer et changer de couleur lorsqu’elle reçoit des informations, elle peut donc recevoir des informations,
- elle embarque des capteurs (gyroscope, accéléromètre…) et peut transmettre des données,
- elle communique avec l’extérieur en Bluetooth Low Energy qui est un des protocoles de communication de l’IOT (mais vous avez aussi le wifi, zigbee, etc.).
Le plus souvent, les Things n’ont pas la capacité de communiquer directement avec les infrastructures (donc se connecter à internet), il est donc nécessaire de mettre en place une “Gateway” ou “Hub”, pouvant à la fois communiquer avec les Things et les infrastructures.
Dans le rôle de la “Gateway”, nous avions choisi un Raspberry PI allié aux éléments suivants :
- un dongle bluetooth afin de communiquer avec la Sphero,
- un dongle wifi (ou un cable RJ45) pour se connecter “à l’extérieur”.
Communication entre la Sphero et la Gateway
D’un point de vue logiciel, le Raspberry PI communiquait avec la Sphero grâce au framework CylonJS (http://cylonjs.com) qui s’appuie sur NodeJS (JavaScript est de plus en plus présent dans le monde de l’IOT, même si les Things se programment beaucoup en C, Python ou bien Lua). CylonJS est un projet qui propose les API et les drivers nécessaires pour communiquer avec de nombreux objets, tels l’AR Drone (de la société Parrot), mais aussi la Sphero.
Le “code de pilotage” ressemble à ceci :
Cylon.robot({
connections: {
sphero: {adaptor: 'sphero', port: config.spheroPort()},
},
devices: {
sphero: {driver: 'sphero'}
},
work: function (my) {
// start sphero
my.sphero.roll(5, Math.floor(Math.random() * 360));

after((1).seconds(), function () {
var opts = {n: 200, m: 1, pcnt: 0};
my.sphero.setDataStreaming(["locator", "accelOne", "velocity"], opts);
my.sphero.setBackLED(192);
my.sphero.stop();
});

my.sphero.on("data", function (data) {
// get some data
});
}
}).start();
Communication entre la Gateway et le serveur
Il existe plusieurs protocoles de communication dans le monde l’IOT, pour les besoins de notre démonstration, nous avions choisi le protocole MQTT (Message Queue Telemetry Transport), dont les initiateurs principaux sont IBM et Eurotech. MQTT a été standardisé à l’OASIS en novembre 2014. Nous l’avons choisi car c’est un standard simple et léger, reposant sur TCP/IP, utilisant un modèle évènementiel et il est “content agnostic”.
Le modèle évènementiel de MQTT repose sur l’application du pattern “publish / subscribe”, il faut donc un serveur de message (on parlera de broker MQTT) et des clients MQTT pour publier des messages ou s’abonner à des channels de messages, on parlera de topics.

Un autre avantage de MQTT est qu’il existe déjà de nombreuses implémentations de brokers et de clients dans différents langages.
Dans le cadre de notre démonstration nous avons utilisé Mosca comme broker MQTT (il repose sur NodeJS), donc installé sur un laptop qui faisait office de serveur.
Côté “Gateway” (sur le Raspberry PI donc), il se trouve que le projet CylonJS propose aussi un driver MQTT (à retrouver ici), le code de pilotage de la Sphero a donc été très facile à modifier :
Cylon.robot({
connections: {
sphero: {adaptor: 'sphero', port: config.spheroPort()},
server: {adaptor: 'mqtt', host: mqttServer}
},
devices: {
sphero: {driver: 'sphero'}
},

work: function (my) {
// S’abonner à tous les topics de type /sphero/*
my.server.subscribe('/sphero/+');

// start sphero
my.sphero.roll(5, Math.floor(Math.random() * 360));

my.server.on('message', function (topic, data) {
// à la réception d’un message en provenance du serveur,
// je déclenche les mouvements de la Sphero
data = JSON.parse(data)
if (topic == "/sphero/move-sphero") {
my.sphero.roll(data.speed, data.angle);
}
if (topic == "/sphero/stop-sphero") {
my.sphero.stop();
}
});

my.sphero.on("data", function (data) {
// lorsque la Sphero se déplace je renvoie les informations au serveur (broker)
// sur le topic hello-sphero
my.server.publish("hello-sphero", JSON.stringify(data));
});
}
}).start();
Parties 2, 3 & 4 : le serveur, les données et les dashboards
Le serveur de la démonstration (un portable) comportait plusieurs composants :
- NodeJS pour faire fonctionner le broker MQTT et le serveur d’application,
- le broker MQTT Mosca, présenté plus haut,
- une application web développée avec ExpressJS qui fournissait à la fois une API (obtenir la liste des objets connectés et leurs informations via une API REST, par exemple : http://my_iot_server/connected/things) et le front web,
- une base Redis (qui contenait la liste des objets connectés et leurs informations),
- une webapp développée avec Polymer qui fournissait des informations graphiques (les dashboards) à propos de la Sphero (grâce au framework Epoch à base de D3.js).
Pour permettre des échanges temps réels sur toute la chaîne de communication de la Sphero jusqu’au navigateur, nous avons utilisé côté serveur le framework socket.io et côté navigateur, le client socket.io.js du même projet : donc tous les messages MQTT en provenance de la Sphero via la Gateway et le broker étaient transmis via socket au navigateur, et de la même façon, l’interface web permettait d’envoyer des informations de pilotage à la Sphero pour la faire bouger ou changer de couleur.
Ces éléments permettaient d’illustrer un cheminement complet de l’objet vers le broker, puis le client, et ensuite renvoyer des données dans le sens inverse, vers l’objet :


Le dashboard “Sphero” en pleine action
La Sphero est un objet ludique, mais imaginez à la place un éclairage de ville dont on pourrait facilement gérer l’intensité, la couleur (ambiance), ou même détecter des problèmes physiques (collision avec véhicule…) et vous comprendrez l’utilité de l’IOT.
Il ne faut pas oublier non plus que les objets sont plus ou moins “intelligents” (logiciels embarqués), communicants et puissants : si la Sphero a besoin d’une Gateway qui permet de faire “le pont” vers internet, mais aussi qui “embarque” le client MQTT pour échanger avec le serveur, certains objets peuvent communiquer directement en wifi et embarquer la partie logicielle (donc plus besoin de Gateway).
Ce cas de figure était l’objet d’une autre démonstration qui mettait en œuvre un micro controller ESP 8266 à peine plus gros qu’un sucre embraquant un client MQTT codé en C, et capable de communiquer directement en wifi (et pour un prix dérisoire de l’ordre de 5$).

L’ESP 8266
L’ESP 8266 était relié à un capteur de température et à un écran à cristaux liquides et sur le même principe que la démonstration précédente il était possible d’interagir à distance avec l’ESP 8266 (envoyer la température vers le serveur, envoyer des informations du serveur vers l’écran : globalement nous avions un début de NEST). La seule différence était que ce nouvel objet se passe de Gateway, car il embarque à la fois les moyens de communication et l’intelligence.

Nest Like par @lhuet35
Notre objectif à travers ces démonstrations était double : illustrer l’Internet des Objets, mais aussi démontrer que, simplement, on peut être acteur de ce nouveau monde et faire son propre Internet des Objets.
Quelques idées pour aller plus loin
Il faudrait beaucoup plus de pages et de temps pour être exhaustif, mais voici quelques points supplémentaires si vous souhaitez creuser plus en profondeur le sujet :
- il existe d’autres protocoles, et notamment CoAP (Constrained Application Protocol) pensé pour les réseaux LoWPAN (Low-Power Wireless Personal Area Network), des réseaux de “toutes petites” machines,
- tous ces objets génèrent beaucoup de données qu’il faut pouvoir exploiter. Après avoir assisté à la présentation de Nicolas Muller à Devoxx France 2015 sur InfluxDb et Grafana, je ne saurai que trop vous conseiller de jouer avec,
- les composants et les kits de démarrage “électroniques” avec des micro-controllers ou des nano-computers sont de plus en plus abordables et vous permettent de prototyper des objets avec des capteurs très facilement, par exemple mon prochain jouet sera certainement un “Grove Starter Kit” (ou comment faire de l’électronique façon Lego lorsque l’on n’y connait rien du tout).
Cet article Comprendre l’IOT avec une boule… mais pas que... est apparu en premier sur Technologies e-business.
]]>Cet article Découverte des Chrome Apps Mobiles est apparu en premier sur Technologies e-business.
]]>
(c) Chrome
Il est tentant de penser que les Chrome Apps mobile s’exécutent en s’appuyant sur l’application Chrome installée votre device (que ce soit sur Android ou sur IOS). Il s’agit en réalité d’une chaine de compilation – actuellement en mode Developer Preview (c’est-à-dire, pas encore stable) – qui s’appuie sur Apache Cordova pour créer des applications natives à partir du code d’applications Chrome. Nous allons faire un tour d’horizon sur ce toolkit et les particularités des applications Chrome pour mobile.
Quelques rappels sur Cordova
 Cordova permet de créer des applications natives pour plateformes mobiles (entre autres pour Android, IOS, BlackBerry, etc.) à partir d’application Web codées en HTML et JavaScript, tout en offrant un ensemble d’API plus puissantes permettant de tirer parti des fonctionnalités offertes par le matériel. Ainsi, avec une application Cordova, on pourra facilement accéder aux fonctionnalités de l’accéléromètre, la boussole, la géolocalisation, le stockage hors-ligne, la caméra, le système de notifications.
Quand Adobe a relâché PhoneGap à la communauté Open Source, il a été appelé Cordova et réversé à la fondation Apache. Google contribue activement au développement de Cordova. Notamment sous la forme de plugins Cordova qui implémentent les API Chrome. L’idée est de proposer les API « clés » de Chrome pour les utiliser au sein des plateformes Android et IOS. Cordova va créer une application « coquille » native autour de notre application Chrome codée en HTML et JavaScript. Pour les rappels sur l’utilisation de Cordova, n’hesitez pas à jeter un œil sur l’article « Créer des applications hybrides avec PhoneGap » publié dans Programmez n°164.
La Chrome App s’exécute au sein des Webviews d’applications natives créées avec Cordova. Sur IOS, c’est le UIWebControl. Sur Android, seul KitKat (Android 4.4) propose un WebView s’appuyant sur un moteur Chromium (l’implémentation Open Source de Chrome) et qui inclus donc les avancées du moteur Javascript V8 ainsi qu’un meilleur support des standards Web. Cependant, cette version de Chrome est pour l’instant limitée à la version 30 et vit indépendamment de la version « application » installée. L’implémentation de Chrome dans les Webviews comporte également donc encore quelques limitations. Pour les versions antérieures d’Android, on s’appuie sur le moteur de rendu du Android Browser (qui lui, est basé sur WebKit).
Limitations
Il y a plusieurs limitations à l’heure actuelle, car les outils sont encore en cours de développement, notamment, certaines fonctionnalités Web sont désactivées ; heureusement elles sont portées par Cordova. Ainsi une application Chrome peut ne pas fonctionner telle quelle sur Mobile. La plupart des problèmes ergonomiques sont également recensés, car une application Dekstop ne réagira par identiquement qu’une plateforme Mobile :
- Problèmes de layout sur des petits écrans, notamment en orientation portrait. Utiliser les media-queries CSS permet d’optimiser l’affichage du contenu pour les plus petits écrans.
- La taille des fenêtres indiquées via chrome.app.window sont ignorées et prennent la dimension de l’écran du mobile. Il est préférable de supprimer les dimensions codées en dur et de concevoir son application avec différentes tailles à l’esprit.
- Les boutons de petite taille et les liens sont durs à taper avec les doigts. Il est recommandé de faire en sorte que les éléments à toucher soient au minimum en résolution 44×44 px.
- Les événements de survol de souris ont un comportement incertain. Il est préférable d’ajouter des interactions également sur les événements tap (notamment pour l’affichage de menus déroulants par exemple).
- Un délai de tap de 300 ms. Pour ce dernier point, certaines solutions techniques autour de librairies tierces FastClick, ou des mises à jour de Chrome (à partir de la version35) corrigent ce point.
Beaucoup d’API sont disponibles, parmi lesquelles : identity (OAuth2), Payments, pushMessaging, sockets, notifications (seulement Android), storage, syncFileSystem, alarms, idle, power. Cependant, toutes les API JavaScript de Chrome ne sont pas implémentées et toutes les fonctionnalités des applications Chrome « Desktop » ne sont pas disponibles : notamment, la balise webview, indexedDB, getUserMedia(), le code natif NaCL. Le tableau ci-dessous recense les fonctionnalités portées sur mobile par plateforme :

1) Les alarmes ne se déclenchent que si l’application est au premier plan
2) Les méthodes JS (chrome.i18n) sont fonctionnelles mais pas les instructions CSS.
3)Qualité Bêta
4) Local storage only. Le sync storage fonctionne en mode dégradé (comme storage.local)
5) Qualité Alpha
Cette liste va évoluer au fur et à mesure de l’avancement, les détails sont disponibles ici.
Installation
Dans cette partie nous allons nous concentrer sur la création d’un nouveau projet pour la plateforme Android. L’installation et la création de projet pour la plateforme IOS sont similaires en adaptant à l’IDE XCode.
Pour les deux plateformes
Il faut installer Node.js et le plugin Chrome-Cordova-Application (CCA).
Node.js est nécessaire pour les installations suivantes et la gestion de dépendances via NPM. Il suffit de récupérer l’installeur sur le site officiel et de lancer l’installation standard.
Chrome-Cordova-Application intègre Cordova ainsi que les plugins nécessaires à la constitution de l’application Chrome mobile. L’installation se fait via npm en lançant la commande npm install –g cca.
Pour Android
Il faut commencer par installer Java JDK et le SDK Android sous C:\Development\android-sdk-windows par exemple.
La variable d’environnement PATH doit contenir le chemin vers les tools et platform-tools du SDK :
C:\Development\android-sdk-windows\platform-tools
C:\Development\android-sdk-windows\tools
Il faut également s’assurer de l’ajout du SDK cible (depuis le Android SDK Tools) ainsi que du driver du device. A cette étape, la commande android et tous les outils associés doivent être accessibles en ligne de commande et le device doit être reconnu par adb.
Pour IOS
Pour le développement IOS, il est nécessaire d’utiliser Mac OS, installer XCode 5. Nous utilisons également ios-deploy pour installer et déployer des applications depuis la ligne de commande. Ios-deploy s’installe en lançant la commande npm install –g ios-deploy, ainsi que ios-sim () pour nous permettre de lancer l’application sur le simulateur en ligne de commande. ios-sim s’installe depuis npm en lançant la commande npm install –g ios-sim.
Vérification
Vérifier si tout est bien installé en lançant la commande cca checkenv:
$ cca checkenv
cca v0.0.9
## Checking that tools are installed
Android SDK detected.
A noter que l’étape de checkenv sera effectuée à chaque fois que la commande cca est lancée. Pour utiliser Cordova avec une application Chrome existante, on utilisera l’outil cca (Cordova Chrome App) en ligne de commande.
Création d’un nouveau projet
Il est possible de créer un projet vide ou de créer un projet à partir des sources d’une application Chrome existante.
Pour la création d’un projet vide :
$ cca create MonApp
MonApp représente le nom de l’application.
Si les sources de l’application Chrome existent déjà, il est possible de les importer lors de la création du projet en utilisant la commande :
$ cca create YourApp --copy-from=path/to/manifest.json
Les ressources seront alors copiées dans le répertoire www. On obtient alors l’arborescence suivante :

Spécificité des développements Chrome App mobile
Cycle de vie et événements
Dans le modèle Chrome, les applications peuvent être notifiées par plusieurs évènements de cycle de vie applicatif. Ils sont notamment lancés lorsque l’application se lance et s’arrête ou en réponse à certaines actions utilisateur, comme l’installation de mise à jour. Comprendre ceci est crucial pour développer une application qui peut sauver et restaurer son état effectivement sur un desktop et mobile.

On compte parmi les évènements : onRestarted, onInstalled, onLaunched, onSuspend, onSuspendCancelled. Malgré le fait que ces événements soient disponibles sur les différentes plateformes, ils ne sont pas déclenchés au même moment et ils ont une sémantique différente entre l’environnement Desktop et l’environnement mobile dont il faut avoir conscience pour le développement de son application Chrome App Mobile.
Sur Desktop :
- Au lancement, la page background est lancée ;
- onRestarted peut être lancé si Chrome s’est arrêté inopinément ;
- onInstalled peut être lancé si l’application vient juste d’être installée ou mise à jour ;
- Quand l’application est lancée : onLaunched est déclenché ;
- Quand toutes les fenêtres de l’application sont mises en arrière-plan, l’application peut être suspendue. Dans ce cas, onSuspend est déclenché.
- Si l’application est remise au premier plan, avant d’être terminée, onSuspendCanceled est déclenché.
Sur Mobile :
En général, les utilisateurs ne ferment pas les fenêtres ni les applications directement. C’est l’OS qui s’occupe de fermer les applications (elles sont suspendues et peuvent être terminées à n’importe quel moment), mais l’utilisateur n’en a pas conscience, car les applications ne sont pas visibles en même temps. La plupart des applications ne démarrent pas sans l’intention d’être lancées et ne tournent pas en arrière-plan (dès qu’elles sont cachées, elles sont suspendues).

Ainsi l’évènementiel du cycle de vie est différent, trois évènements peuvent apparaître lors du démarrage :
- onRestarted : seulement si l’application s’est arrêtée prématurément. Cela signifie qu’un évènement précédant onSuspend n’a pas été exécuté jusqu’au bout.
- onInstalled – quand la version indiquée dans le manifest.json a changé (et donc également lors de la première installation).
- onLaunched – dans tous les cas au lancement de l’application étant donné que les applications sont immédiatement lancées au démarrage sur mobile.
Ces évènements seront lancés après que les scripts background aient été exécutés, il faut donc attacher des listeners pour ceux-ci. Si l’application n’est pas éteinte, et est seulement remise au premier plan, seul onSuspendCanceled sera déclenché.
Lors d’une reprise :
- Chaque fois que l’utilisateur switche d’application, l’application Chrome devient suspendue. onSuspend est déclenché, parce que l’OS peut détruire l’application à n’importe quel moment.
- Si l’utilisateur revient sur l’application avant que l’OS ne l’ait détruite, onSuspendCanceled est déclenché.
- C’est la responsabilité de l’application de sauver son état quand onSuspend est appelé.
- Si l’application est tuée par l’OS pendant que l’application est proprement suspendue, c’est un arrêt « propre ». Lors du prochain démarrage, onLaunched sera donc déclenché.
- Si l’application est tuée par l’OS alors que la suspension est incomplète, alors, onSuspendCanceled ne sera déclenché, mais à la place onRestarted.
Manifest Mobile
Le fichier manifest.mobile.json est un complément au manifest.json qui permet d’indiquer les paramétrages spécifiques aux applications mobiles. Par exemple, les spécifications de version de Android (versionCode) ou IOS (CFBundleVersion), et qui n’apparaissent donc pas dans le Manifest générique.
{
"packageId": "com.your.company.HelloWorld",
"versionCode": 1,
"CFBundleVersion": "1.1.1"
}
La documentation des API indique si des propriétés doivent être ajoutées spécifiquement au fichier manifest.mobile.json. La commande cca prepare va ensuite constituer les fichiers natifs en récupérant les paramétrages issus des manifest.json et manifest.mobile.json. Par exemple, le Manifest Android (Manifest.xml nécessaire à la constitution de l’APK) : le champ android:versionName est déduit de la version de l’application renseignée dans le manifest.json et le champ android:versionCode est déduit du fichier manifest.mobile.json. La commande cca prepare est automatiquement ré-exécutée lors des commandes cca build, cca run ou cca emulate. Par contre, lors du développement depuis l’IDE, elle ne sera pas exécutée. Il faudra donc lancer la commande cca prepare manuellement pour s’assurer que les modifications des manifest Chrome soient correctement prises en compte.
Déploiement
Deux options sont envisageables pour le développement pour compiler, packager et tester l’application : utiliser l’outil en ligne de commande, ou alors les lancer depuis l’IDE. Dans les deux cas, vérifiez que le mobile est connecté en USB et reconnu par Eclipse ADT ou Xcode.
Lors de l’étape d’empaquetage, l’application native est créée (sous la forme d’un APK pour Android et d’un IPA pour IOS) et les ressources Web de l’application Chrome sont intégrées à l’application. A cette étape, il n’y a rien de spécifique à Chrome, ni à CCA. A noter que comme l’application native est créée, il faudra disposer des certificats disposer des certificats (et donc d’un compte développeur pour IOS).
Pour plus de détails sur ce point et sur le lancement d’application depuis l’IDE, n’hésitez pas à aller voir à cette adresse pour plus de détails sur le Github.
Le déploiement peut se faire comme une application native classique, à savoir sur un émulateur en lançant les commandes cca emulate android ou cca emulate ios respectivement pour les cibles Android et IOS, ou alors directement sur le device en lançant les commandes cca run android ou cca run ios.
Debugger avec Chrome Apps Developper Tools (Android only)
Le Chrome Apps Developer Tool (Chrome ADT) est une application Android qui permet de télécharger et exécuter une application Chrome sans utiliser l’outil cca. L’application est encore en cours de développement (pre-alpha) mais il est déjà disponible en version pré-packagé APK à cette adresse : https://github.com/MobileChromeApps/harness/releases/ (prendre la dernière version construite). Elle pourra être installée sur le mobile de tests. Cette application Chrome ADT offre deux facilités pour le développeur, pour exécuter des applications Chrome sans passer par la constitution d’une application native de la commande cca build.
Test à partir de CRX
Cette fonctionnalité permet d’avoir un aperçu rapide d’une application Chrome déjà packagée en CRX (issu d’une application empaquetée pour Chrome Desktop) sur le device Android, sans passer par une phase de packaging CCA.
Test à partir des sources statiques
Ici, on utilise seulement CCA pour « servir » les ressources web (HTML, CSS, JS, etc.) que l’application Chrome ADT pourra exécuter au sein d’un conteneur de test. Pour cette dernière option, on utilise la commande « cca serve » qui va créer un serveur web de ressources statiques (par défaut sur http://localhost:8000).
D:\projets\MonApp>cca serve
cca v0.0.9 …
Static file server running on port 8000 (i.e. http://localhost:8000)
CTRL + C to shut down
Depuis, l’application Chrome ADT, on indique l’URL sur laquelle cette application est servie, à savoir : http://<adresse_ip>:8000
Le gros avantage de l’outil est de supprimer les étapes d’empaquetage natif, qui peuvent être assez longues et répétitives, surtout pendant la phase de développement. Le cca serve offre en plus la possibilité de servir les ressources à chaud (dès qu’elles sont modifiées, elles sont disponibles), côté Chrome ADT, un simple « Update » permet d’avoir à disposition la dernière version de l’application. Un gain de temps considérable !

Exemple de l’application Chrome ADT (à gauche) – et l’application Calculator ‘servie’ et en test à droite.
Distribution
Les applications Chrome Desktop sont distribuées sur le Chrome Web Store (http://chrome.google.com/webstore), alors que CCA encapsule les applications Chrome mobiles dans une application native et sont donc, quant à elles, distribuées sur les Store mobile dédiés, à savoir Play Store pour Android, et l’App Store pour IOS.
La distribution sur le Chrome Web Store est minime (5$), mais augmente pour le Play Store (25$) et encore plus pour l’AppStore (99$/an). C’est un point à prendre en compte également si l’on souhaite ouvrir son application à plusieurs canaux !
Conclusion
Pour les développeurs qui cherchent un moyen rapide de développer une application sur du multi-device, les applications Chrome Cordova Mobile fournissent une des solutions les plus faciles à mettre en place. L’outillage basé sur Cordova permet d’avoir une base de commune ce qui permet aux développeurs d’avoir une application native et réellement portable sur tous les supports sans avoir à entrer trop en détails sur les spécificités de Android et IOS.
Pour l’instant les API disponibles sont encore limitées, mais gageons que les équipes de développement de Chrome sauront enrichir leur outil pour permettre l’accès à toutes les API et offrir des fonctionnalités équivalentes entre Desktop et Mobile.
Cet article Découverte des Chrome Apps Mobiles est apparu en premier sur Technologies e-business.
]]>Cet article Tour d’horizon du développement Chrome Apps est apparu en premier sur Technologies e-business.
]]>
Une application Chrome, c’est quoi ?
Une application Chrome (« Chrome App ») est avant tout une application développée avec les technologies du Web : HTML5, JavaScript et CSS. Ces langages vont constituer la base de l’application. On tire ensuite parti des possibilités nouvelles d’HTML5 et des API spécifiques de Chrome pour enrichir l’application. Et c’est surtout sur ce dernier point que Chrome va apporter tout son intérêt car l’API est ouverte et propose un éventail de fonctionnalités permettant d’aller beaucoup plus loin que des applications Web puisqu’il donne l’accès aux routines plus proches de l’OS et du matériel. L’application va donc pouvoir se comporter comme une application de bureau tout en tirant parti des facilités de développement en HTML et JS.
Avant d’aller plus loin et éviter les confusions, nous allons d’abord faire un rappel sur la différence entre une application Web, application Chrome, et extension Chrome.
Application Web vs Application Chrome ?
Une application Web est un site « enrichi » en tirant parti de JavaScript et des fonctionnalités d’HTML5 pour offrir une expérience améliorée à l’utilisateur mais s’exécutant dans le navigateur. L’application Web est « connectée » et standard (indépendante du navigateur).
Une Chrome App est une application de bureau et offre une grande immersion à l’utilisateur en tirant parti de l’OS et des capacités matérielles. L’application Chrome est prévue pour fonctionner en mode déconnectée et s’appuie fortement sur les fonctionnalités du navigateur.
Application Chrome ou extension Chrome ?
 Une extension est un complément de Chrome, elle n’a pas de fonction propre en dehors de Chrome. Elle permet d’ajouter des fonctionnalités supplémentaires à Chrome (par exemple accessibles via un nouveau bouton dans la barre d’adresse).
Les applications sont, quant à elles, indépendantes et autonomes. Une application s’appuie sur Chrome seulement pour son exécution, mais elle en est indépendante.
Exemple d’application Chrome « Calculette ». Elle utilise le thème natif de l’OS sur lequel elle s’exécute.
Généralité
Avant d’entrer plus en détails, voici quelques généralités des Chrome Apps :
Mode Offline
Une Chrome App est déconnectée par défaut. Cela permet de mettre en avant l’approche offline first et concevoir l’application pour fonctionner non seulement en étant déconnecté, mais surtout pour répondre plus facilement aux cas pour lesquels le réseau est lent, pas fiable, ou si les serveurs sont indisponibles temporairement. L’application Chrome apporte un plus ici car l’intégralité du package de l’application est téléchargée et disponible sans nécessité de connexion ultérieure pour son exécution.
Multi-device, multi-plateforme
Une Chrome App fonctionne sur la plupart des plateformes populaires sur lesquelles Chrome existe : Windows, Mac OS, GNU/Linux, mais aussi Android et IOS.
Immersif
L’application Chrome interagit avec l’OS hôte et avec le matériel (USB, Bluetooth, socket TCP, etc.). L’application est intégrée à l’OS (raccourcis, style de fenêtre adaptée, mode plein-écran)
Distribué
L’application Chrome est distribuée et mise à jour via Chrome Web Store. Cette approche permet également de simplifier la monétisation de l’application mais également des feedbacks rapides et facilités des développeurs.
Cloud
Une application Chrome est « cloud-enabled » par défaut. C’est-à-dire, que l’API propose des accès aux services Google permettant de faciliter le travail du développeur qui n’a rien de plus à coder pour les accès aux données, notamment les services Storage Sync, syncFileSystem, pushMessaging API.
Sécurisé et isolé
Les Chrome Apps implémentent Content Security Policy : en Javascript, pas d’utilisation de eval(), new Function, etc. L’exécution des processus est isolée (principe de Sandboxing) : un plantage d’une application Chrome ne fera pas planter l’application voisine. Même principe de Sandboxing concernant le stockage des données applicatives qui est, lui aussi, isolé. Autre point de sécurité une application Chrome n’a accès qu’aux API Web standard et Chrome Apps, mais ne dispose pas des accès aux API de Chrome Extensions.
Le lanceur d’applications Chrome
L’intérêt de toutes ces fonctionnalités est évidemment l’intégration à Chrome OS. Toutes applications de Chrome OS sont des Chrome Apps, mais il est possible d’en tirer parti dès aujourd’hui directement au sein de votre OS habituel.
Dès la première installation d’une application Chrome depuis le Web Store, le lanceur d’application Chrome va s’installer. Ce lanceur répertorie toutes les Chrome Apps et constitue un point central pour le lancement des applications, sans avoir à lancer le navigateur Chrome.
Il permet également de créer des raccourcis directement sur le bureau ou la barre des tâches pour faciliter d’avantage l’accès aux applications.
Maintenant que l’on connaît les généralités sur les applications Chrome, voyons en détail comment elles sont constituées et comment en programmer une.
Organisation des sources du projet
Une Chrome App est organisée comme un projet Web classique (index.html, assets) et comporte plusieurs fichiers complémentaires : le Manifest, le background page et les icônes :
assets/
       images/
       scripts/
       css/
 manifest.json
 main.js
 index.html
 icon16.png
 icon48.png
 icon128.png
Le Manifest
Le Manifest (manifest.json) est un fichier important nécessaire à l’application Chrome. Il décrit son point d’entrée, ses ressources, ses autorisations d’accès. Il est décrit au format JSON. Les informations minimales sont le nom et la version. Ainsi, une version minimale pourrait être définie comme :
{
  "manifest_version": 2,
  "name": "My App",
  "version": "versionString",
  "default_locale": "en",
  "description": "A plain text description",
  "icons": {...},
  "app": {
    "background": {
            "scripts": ["background.js"]
    },
  },
  "permissions": ["<all_urls>"]
}
On retrouve ces principales informations :
- Le descriptif de l’application : nom, version, description, locale (langue)
- Le fichier « point d’entrée » de l’application (background)
- Les icônes associées (icons)
- Les permissions (permissions)
- Informations et paramétrages spécifiques aux API (storage, webviews, usb, bluetooth), au système de mise à jour, version minimale de Chrome (sur lesquels on ne va pas s’étendre dans cet article).
En savoir plus sur le contenu du manifest.
Revenons plus en détails sur les permissions, icônes et point d’entrée dans les 3 prochains chapitres.
Les permissions
Pour utiliser la plupart des API, l’application doit déclarer explicitement ses intentions dans le manifeste. Les permissions sont ensuite affichées à l’utilisateur permettant de savoir quels sont les besoins de l’application. Les permissions aident à limiter les dommages si l’application est compromise par des malwares. Certaines permissions peuvent être facultatives. Les permissions peuvent être affichées à l’utilisateur avant l’installation (ou à tout moment sur la page des extensions chrome://extensions).
Parmi les permissions les plus utiles, le pattern « [scheme]:[host]/* » spécifie les URL vers lesquelles l’application souhaite communiquer. En effet, pour éviter les attaques de types XSS, il est nécessaire d’indiquer explicitement toutes les URL auxquelles on souhaite accéder. Heureusement ici, il est possible de faire du Pattern Matching pour nous faciliter la tâche.
Quelques exemples :
- http://*/* : toutes les URL qui matchent le protocole http. Par exemple http://www.google.com/
- file:///foo* : tous les accès aux fichiers locaux dont les fichiers commencent par foo*
- <all_urls> : matche toutes les URL
Parmi les autres permissions, on retrouve les accès aux alarmes (alarms), notifications (notifications), périphérique USB (usb), synthèse vocale (tts) stockage (storage), video (videoCapture), etc. La liste des permissions complète est disponible à cette adresse : https://developer.chrome.com/apps/declare_permissions. Dans tous les cas, la documentation de l’API de Chrome indiquera toujours quelles permissions accorder pour qu’une API soit utilisable.
Les permissions apparaissent dans le Manifest.
"permissions": [
  "serial",
  "storage",
  "videoCapture"
],
Le point d’entrée de l’application
L’Event page est référencée dans le Manifest par le mot-clé « background » et indique un fichier Javascript associé. C’est ce fichier JS qui va constituer le point d’entrée de l’application en agissant sur les évènements systèmes liés à l’application (lancement, redémarrage). Nous préconisons de bien prendre en compte le nouveau modèle de chargement évènementiel Event page dont le détail est expliqué ici. L’ancienne façon de faire, appelée, « Background page », bien qu’elle soit toujours opérationnelle, n’est pas préconisée car moins performante.
Les évènements de pages ne sont lancés qu’en cas de besoin et respectent le cycle de vie applicatif. L’évènement chrome.app.runtime.onLaunched est appelé au lancement de l’application. Nous lui associons une fonction grâce à addListener. Dans la fonction associée, nous créons une nouvelle fenêtre, avec la page « index.html » en indiquant la taille et position de la fenêtre. Le cœur du traitement de l’application est ensuite fait depuis la page « index.html », comme une application web standard.
chrome.app.runtime.onLaunched.addListener(function() {

  chrome.app.window.create('index.html', {
    id: "helloWorldID",
    bounds: {
      width: 500,
      height: 300,
      left: 0,
      top:0
    }
  });
});
Les icônes
Une ou plusieurs icônes représentant l’application sont à fournir. Au moins une : idéalement en format 128×128 pixels. C’est cette icône qui sera utilisée pour représenter l’application sur la page des applications, page de management, barre d’outils, etc. Il est préférable d’utiliser le format PNG car il offre une gestion de la transparence sans perte de qualité. La taille 48 est utilisée sur la page d’administration de l’application (celle qui apparaît sous Chrome://extensions).
"icons": { "16": "icon16.png",
           "48": "icon48.png",
          "128": "icon128.png" }
Attention toutefois, pour la phase de publication sur le Google Web Store, il sera également nécessaire de fournir une autre série d’images, les screenshots. Il est conseillé de mettre au moins la version 128. Chrome ajustera les autres tailles en se basant sur l’image en meilleure résolution s’il ne trouve pas les tailles plus réduites.
Attention à bien respecter les tailles documentées et leurs tailles associées (128×128 pixels pour « 128 », 48×48 pixels pour « 48 ») afin de ne pas avoir de surprise lorsque Chrome tentera de redimensionner ces images.
En savoir plus sur les icônes.
Quelles API ?
Le nombre d’API disponibles pour les Chrome Apps est conséquent : Bluetooth, menu contextuels, système de fichiers, fenêtres sans cadre, plein-écran, géolocalisation, UserMedia (capture de son, vidéo), HID, identité (OAuth2), monétisation in-app, gallerie de média, Google Cloud Messaging, Impression, notifications enrichies, port série, Socket UDP/TCP, stockage, SyncFileSystem, Synthèse vocale, informations systèmes, USB, WebStore, WebView.
Une page d’exemples répertorie des cas types pour un grand nombre de ces API.
A contrario, certaines API Web ont été dépréciées, car elles sont considérées comme des mauvaises pratiques d’interactions, peu performantes ou tout simplement pas adaptées aux applications natives. Ainsi, on ne pourra pas utiliser les window.alert, window.confirm, showModalDialog, document.cookie, document.close, document.open, document.write, la navigation avec URL ou ancres, Flash, la soumission de formulaire, le local storage, WebSQL ou encore les requêtes XmlHttpRequest synchrones. On notera aussi que la sélection de texte par l’utilisateur n’est plus possible par défaut. Comment faire alors ? Faire sans ! Une page liste cependant des contournements possibles pour ces cas précis.
Pour l’édition, comme il s’agit de ressources Web, il n’y a pas d’IDE dédié spécifiquement aux sources d’un projet Chrome app, il est préférable cependant d’utiliser un IDE Web avancé tel que Sublime Text, Brackets, ou encore WebStorm.
Exemple d’API : Sync Filesystem
Nous allons nous voir un exemple de codage en utilisant sur une des API phare : Sync FileSystem. Cette API est utile pour sauver et synchroniser les données vers Google Drive. Elle fournit un stockage spécifique à l’application synchronisable à tout moment, le développeur n’ayant pas à se soucier si l’application est connectée ou non. L’intérêt de ce type de stockage est de partager les données entre plusieurs devices.
L’appel de la fonction syncFileSystem.requestFileSystem retourne un filestystem synchronisable récupérable dans notre fonction de callback onInitFs.
chrome.syncFileSystem.requestFileSystem(onInitFs);
L’objet fs est un DOMFileSystem peut être opéré comme n’importe quel fichier distant ou local. Le filesystem ne supporte pas les opérations sur les répertoires : on peut obtenir la liste des fichiers depuis la racine d’un répertoire, mais pas en créer de nouveaux. Dans notre cas, la fonction de callback getEntryCallback() récupère notre fichier une fois accessible.
function onInitFs(fs) {
    fs.root.getFile('test.txt', {create:true}, getEntryCallback, errorHandler);
}
On récupère l’objet représentant le fichier, puis utilise un FileReader pour lire son contenu. La fonction reader.onloadend est appelée une fois le contenu disponible. Il est disponible via la variable this.result.
Function getEntryCallback(fileEntry) {
    fileEntry.file(function(file) {
       var reader = new FileReader();
       reader.onloadend = function(e) {
         doSomething( this.result);
       };
       reader.readAsText(file);
}
En savoir plus sur l’API fileSystem HTML 5.
Tester son application
Une fois que notre application est correctement organisée et que les principaux fichiers sont présents, elle va pouvoir être chargée pour son exécution. Pendant la phase de développement de l’application, on charge l’application dans Chrome en mode « non-empaquetée ».
Pour charger une application, il faut ouvrir Chrome et se rendre sur la page des extensions (en tapant l’URL chrome://extensions) et cocher l’option « Mode développeur ». Une fois cette option activée, il est maintenant possible de charger l’application en indiquant le répertoire racine de l’application (celui qui contient le manifest.json)

Dans ce mode, les sources sont chargées à partir de leur emplacement actuel et permet un rechargement des sources, ce qui s’avère beaucoup plus productif en phase de développement. Pour le rechargement des sources, il suffit de se positionner sur la page des extensions et faire Ctrl+R (ou cmd+R sous Mac OS)

Pendant la phase de débuggage, la console de développement de Chrome est accessible. Il s’agit bien d’une console propre à notre application et pas celle de Chrome. Pour afficher la console de développement, Clic-droit sur l’application puis « Inspecter l’élément ». Autre point à savoir : la console de développement Web n’est accessible que si l’application est chargée en mode « non-empaquetée ».
Empaqueter l’application.
Bien que les Chrome Apps et Chrome Extensions soient différentes comme on l’a vu précédemment, elles partagent néanmoins le même système d’empaquetage et de distribution. L’application doit être empaquetée pour pouvoir être distribuée. Le packaging est un « zip » accompagné d’un certificat PEM et qui nous constitue au final un package au format CRX. Le certificat PEM est obligatoire en cas de distribution sur le Google Web Store, mais facultatif en cas de distribution hors Store. S’il n’est pas présent il sera généré automatiquement lors du premier empaquetage. Pour empaqueter l’application, deux approches :
Approche manuelle
Depuis Chrome, aller sur la page des extensions, puis cliquer sur « Empaqueter l’extension ». Sélectionner le répertoire source de la Chrome App et le certificat (si présent) puis « Empaqueter l’extension ».

L’extension sera empaquetée dans le répertoire parent de l’application.

Approche scriptée
Il est possible de scripter l’empaquetage de plusieurs manières. La plus simple est d’utiliser Chrome en ligne de commande. Attention à bien indiquer les chemins complets (avec le c:\…) sinon, l’empaquetage ne fonctionne pas et il n’y a pas de message d’erreur pour nous l’indiquer.
chrome.exe --pack-extension=C:\myapp --pack-extension-key=C:\myapp.pem
L’autre approche est d’utiliser l’outil de scripting de son choix ! Le format CRX est un format ouvert (consulter les spécifications du format CRX). On peut donc très facilement créer son propre script d’empaquetage.
Installer l’application
Une fois le package CRX constitué, l’application peut être installée très facilement : il suffit de glisser-déposer le fichier CRX sur la page des extensions.

Chrome propose alors de l’installer. Elle est ensuite disponible automatiquement depuis le lanceur d’applications Chrome (ou ou depuis Chrome via l’URL chrome://apps).

Pour la distribution de l’application et sa mise à disposition sur « Desktop », il faudra, par la suite, la rendre disponible sur le Google Web Store. Nous verrons dans un prochain article comment aller plus loin en ciblant également les plateformes mobiles.
Cet article Tour d’horizon du développement Chrome Apps est apparu en premier sur Technologies e-business.
]]>Cet article Drop your tables with MongoDB à Lyon le 5 mars 2015 est apparu en premier sur Technologies e-business.
]]>- Paysage NoSQL & positionnement de MongoDB
- Modélisation des documents avec MongoDB
- Mongo & les autres technologies
- Coding live avec la stack MEAN
Cette présentation s’adresse à un public technique (DT, architecte, lead technique, geek de compétition, …).

Informations pratiques
Pour vous inscrire, [email protected].
Jeudi 5 mars – 12h00 – 14h00
SQLI – Place Giovanni de Verrazzano – 69009 Lyon
Cet article Drop your tables with MongoDB à Lyon le 5 mars 2015 est apparu en premier sur Technologies e-business.
]]>Cet article DevFest Nantes 2014 : retour d’expérience est apparu en premier sur Technologies e-business.
]]>Je vous invite à me suivre et vous faire vivre une journée au sein du DevFest, plus gros événement français traitant des technologies Google dans son ensemble.
Paranoid Android
Première impression : aucun regret pour le réveil matinal grâce à un accueil sans faille au sein d’un espace bien adapté, une équipe détendue… et un petit-déjeuner des plus complets !
Les lève-tard qui ont le plus de mal à digérer cet effort auroral se seront sans aucun doute laissés séduire par la “cérémonie d’ouverture” conclue de main de maître par l’excellente prestation scénique de Rossi Oddet, qui nous propose de “nous organiser pour réussir”.
Ça y est, mes paupières sont bien décollées. La journée est lancée.
J’ai choisi d’orienter mon parcours vers des sujets plutôt généralistes et donc une majorité de sessions “Découverte”. Les exposés plus techniques étant quant à eux répartis autour de thèmes “Mobile”, “Web” ou “Cloud”.
Are You Experienced ?
Ma matinée débute par une session “expérience utilisateur” : pas de surprise, l’utilisateur doit être au centre du débat…
J’enchaîne sur un talk présentant l’utilisation de Browserify pour une application AngularJS : très didactique, avec du live coding ! On part d’une application AngularJS de base, puis on modularise, on organise et on fait fonctionner du code nodeJS dans le navigateur. C’est clair, c’est propre…
Ma dernière session de la matinée propose d’utiliser le bon outil pour le bon usage, que ce soit en termes de solutions de persistance ou de langage de programmation, et ne pas hésiter à mixer tout ça. Évident ? Pas si sûr, en tout cas de par mon expérience… Et, surprise, voilà que l’on revient me chatouiller l’oreille avec ce concept d’expérience utilisateur : tous ces efforts auraient pour but de lui proposer plus de choses, plus rapidement…
I Feel Good
Il est 12h30. Cette première demi-journée est passée à la vitesse de la lumière, il est temps d’aller se restaurer…et avaler un morceau de sandwich moitié décongelé entre deux coins de murs en 1 minute 46 ? Que nenni ! A l’image du petit déj’, le déjeuner propose une bonne étendue de plats et miniardises, chauds ou froids. Il y a du monde, certes, mais c’est franchement pas mal du tout !
Les conférences ne reprenant qu’à 14h, ce temps est tout à fait propice aux rencontres (ex-collègues, connaissances de connaissances…) et à un tour des stands avec ses attractions high-tech notamment.
The Show Must Go On
La cloche a sonné, il est temps de repartir pour de nouvelles aventures avec une première conférence tournant autour de l’Android Wear, sujet plutôt inconnu pour moi et potentiellement très à mon goût… De quoi bien gérer la digestion et ses effets “tranquillisants” ? Je n’oserais l’avouer… En tout cas, bonne pioche ! Et là encore, on pense avant tout au confort d’utilisation de ces nouveaux objets connectés.
Puis un petit tour dans le monde d’AngularDart qui nous montre comment il peut être rapide et facile d’écrire une application… Un framework productif en bref.
Après une dernière pause et quelques dernières gouttes de café, j’entame la dernière ligne droite avec un retour d’expérience sur du responsive design. Là encore, il sera énormément question d’expérience utilisateur, de persona, d’adaptabilité… même de méthodologie et de communication.
Enfin, le feu d’artifice final avec une présentation des Web Components et de l’implémentation Polymer par l’irrésistible Horacio Gonzalez. Le standard en cours de maturation devrait faire gagner lui aussi en productivité et en confort de développement.
This is the End…
Voilà une journée bien remplie qui touche à sa fin. Mais une journée bien équilibrée et bien rythmée, la qualité de l’organisation et des speakers y étant certainement pour beaucoup !
S’il fallait dégager une tendance de ces quelques heures de conférence, elle tiendrait pour moi en deux mots : User eXperience.
Il est vrai que le terme est un peu repris à toutes les sauces aujourd’hui et il pourrait être perçu comme un effet de mode ou LE buzz word du moment. En tout cas, et j’ai envie d’y croire, il semble exister une remise en question authentique et une réelle volonté de toucher et entendre l’utilisateur dans le développement d’applications…qui lui sont destinées !
Je me risquerai même à aller au-delà et évoquer une Developer eXperience de par la richesse et la multitude de produits permettant une meilleure productivité, un plus grand confort et une meilleure maîtrise des développements. Au final qu’est-ce qu’un développeur si ce n’est lui-même un utilisateur d’outils provenant d’autres développeurs…
Epilogue
La nuit est tombée depuis déjà un petit moment et, comme dans tout bon “Astérix & Obélix” où une fin d’histoire se termine toujours autour d’un bon banquet, le DevFest propose une dernière session : un apéro en musique !
Et c’est donc lors de ce dernier moment de convivialité autour d’une (voire deux…) boisson(s) houblonnée(s) que l’on commence à débriefer sa journée et à refaire le monde… ou tout du moins ses projets en cours… en attendant avec impatience l’édition 2015 et la confirmation ou non des courants actuels…
Cet article DevFest Nantes 2014 : retour d’expérience est apparu en premier sur Technologies e-business.
]]>